
 IXThinker·2026-09-04 13:00
圖靈獎得主:持續學習才是AI下一站
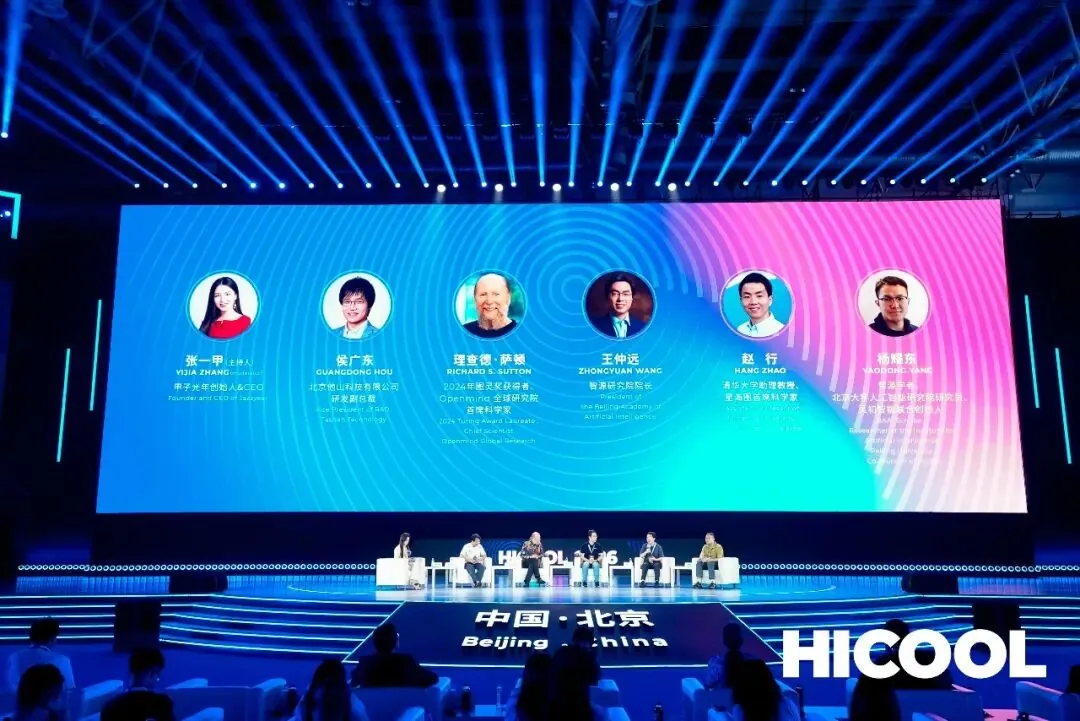
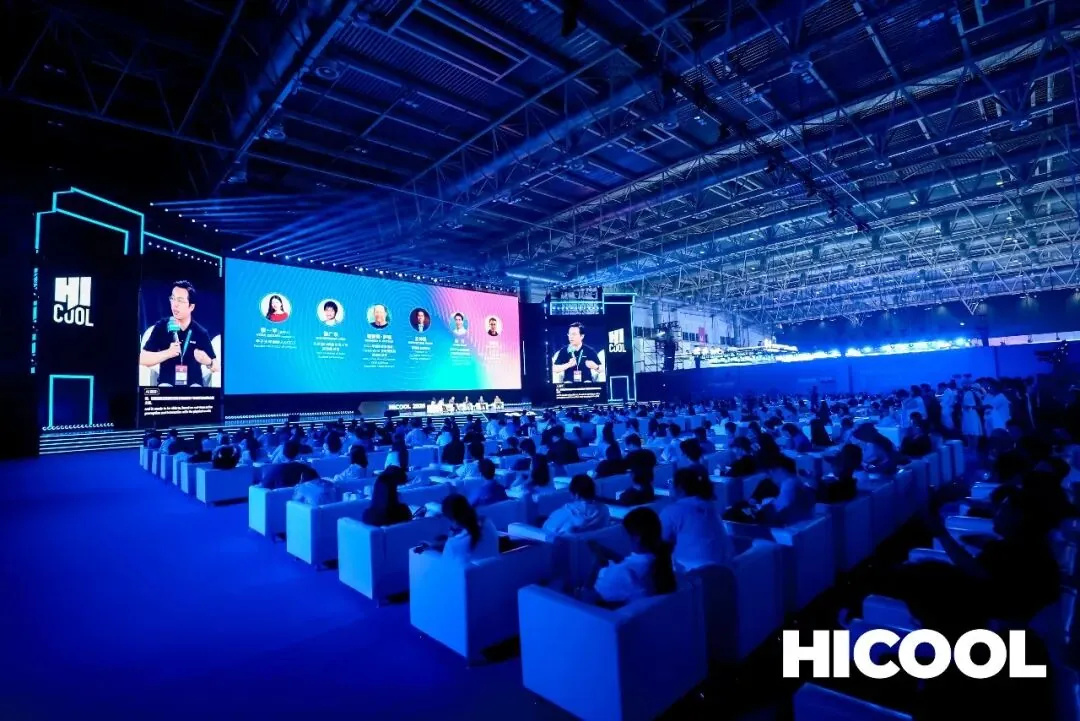
圖靈獎得主Richard Sutton在一場創業者峰會圓桌指出,大語言模型僅限於模仿人類數據、預測下一個詞,正逼近範式邊界;人工智能的下一站是在真實世界中試錯、探索與終身持續學習,並需確保安全可控。
核心觀點
在峰會閉幕圓桌上,圖靈獎得主重申其近年核心主張:如何讓機器在一生中真正地學習。在他看來,大語言模型不過是在模仿人類數據、預測下一個詞、依賴工程師調優,這套範式正在逼近邊界。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。