
 IXThinker·2026-09-16 14:10
詞元級獎勵開新路 3B小模型成功率94.5%
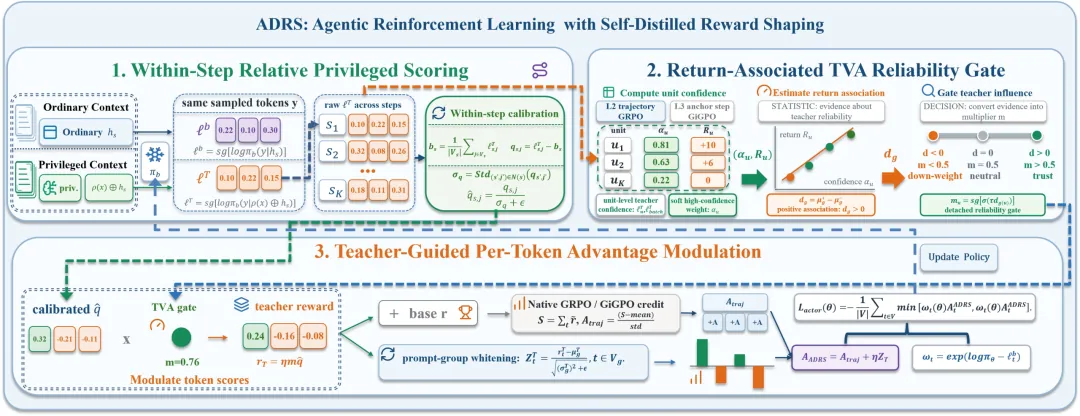
多輪智能體任務往往只有終點獎勵,而軌跡中決定成敗的常是某個查詢詞、動作或對象選擇,形成時間信用分配難題。有高校與企業合作團隊提出以詞元級獎勵精細歸因關鍵決策點,訓練出的3B小模型表現亮眼。
終點獎勵太粗糙
終點獎勵只能告訴模型「這條軌跡最後對不對」,卻無法指出「中間哪一步值得強化」。在搜索、工具調用與多輪決策交織的長軌跡中,這種粗粒度訊號令訓練效率大打折扣。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。