
 IXThinker·2026-09-25 13:30
北大開源強化學習數據策略框架
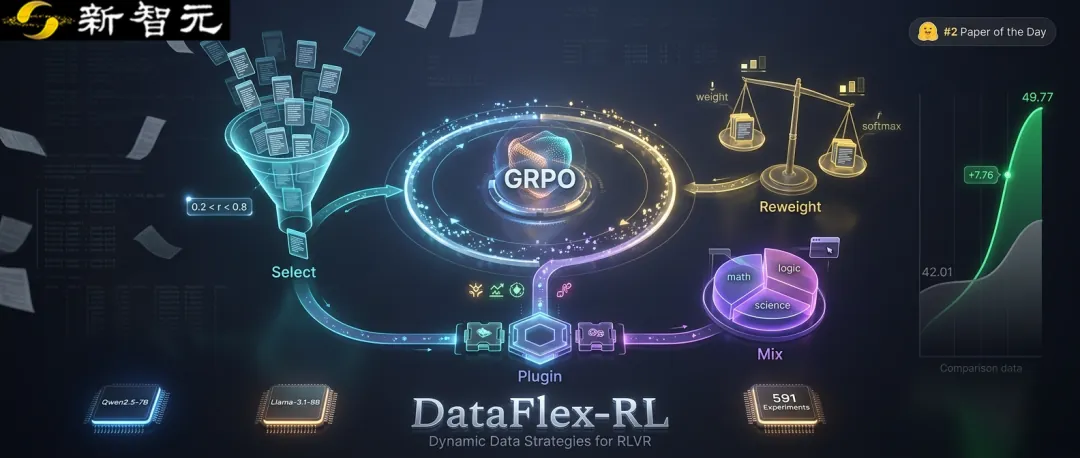
每一輪強化學習到底該把哪些數據交給模型?隨著推理模型與RLVR的發展,這個問題愈發關鍵。北京大學團隊開源新的數據策略框架,讓不同方法的接入更簡單、對比更公平,登上相關日榜第二。
數據要動態調
一道題可能起初很難,訓練一段時間後卻能穩定答對。哪些數據該繼續保留、學習權重與領域配比如何調整,都需要結合模型的實時訓練狀態重新考慮,靜態配置難以適應。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。