
 IXThinker·2026-10-10 12:10
何愷明團隊發布視覺原生VISTA框架
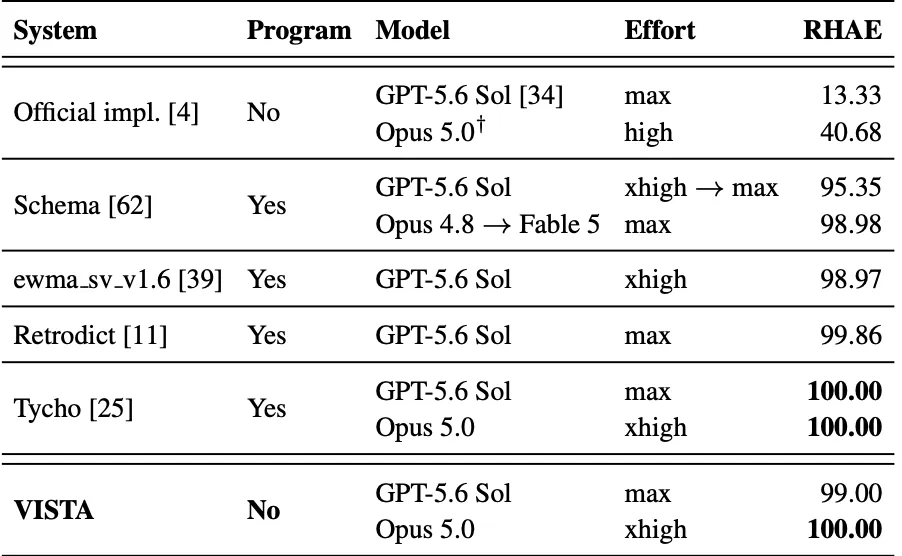
何愷明團隊發表最新論文,提出面向多模態模型的視覺原生框架 VISTA。該框架讓模型直接觀察環境、保存原始畫面,並在推理過程中隨時回看、放大與細查畫面細節,無需重新訓練模型,提升了利用真實視覺信息的能力。
框架核心設計
VISTA 讓現有多模態模型直接觀察環境並保存原始畫面,推理時可根據眼前的問題,把過去看過的畫面重新調入上下文,隨時回看、放大和檢查細節,整個過程不需要從頭訓練模型。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。