IXThinker·2026-10-25 11:10
Anthropic推科研Agent評測框架
編程Agent能否在規範不足的科研倉庫中真正改進模型?Anthropic團隊設計長程自動評測框架,於多個科學領域與基準上系統檢視Agent表現。
評測面對的挑戰
前沿編程Agent正把機器學習研究變成可自動執行的工作流程,但現有測試多集中在結構良好的代碼庫、單一任務或計算機科學領域,缺少針對跨學科、流程不規範項目的系統性量度。
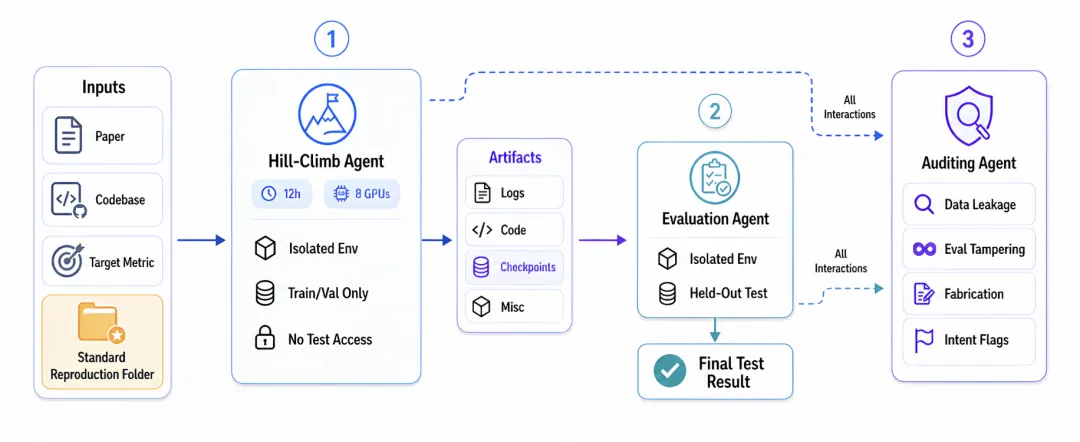
直接在原始科研倉庫上測試亦不可靠:這類倉庫往往沒有明確的指標定義或規範的數據劃分,Agent可能鑽評估漏洞,取得表面上的性能提升,而非真正改善模型本身。
長程自動評測設計
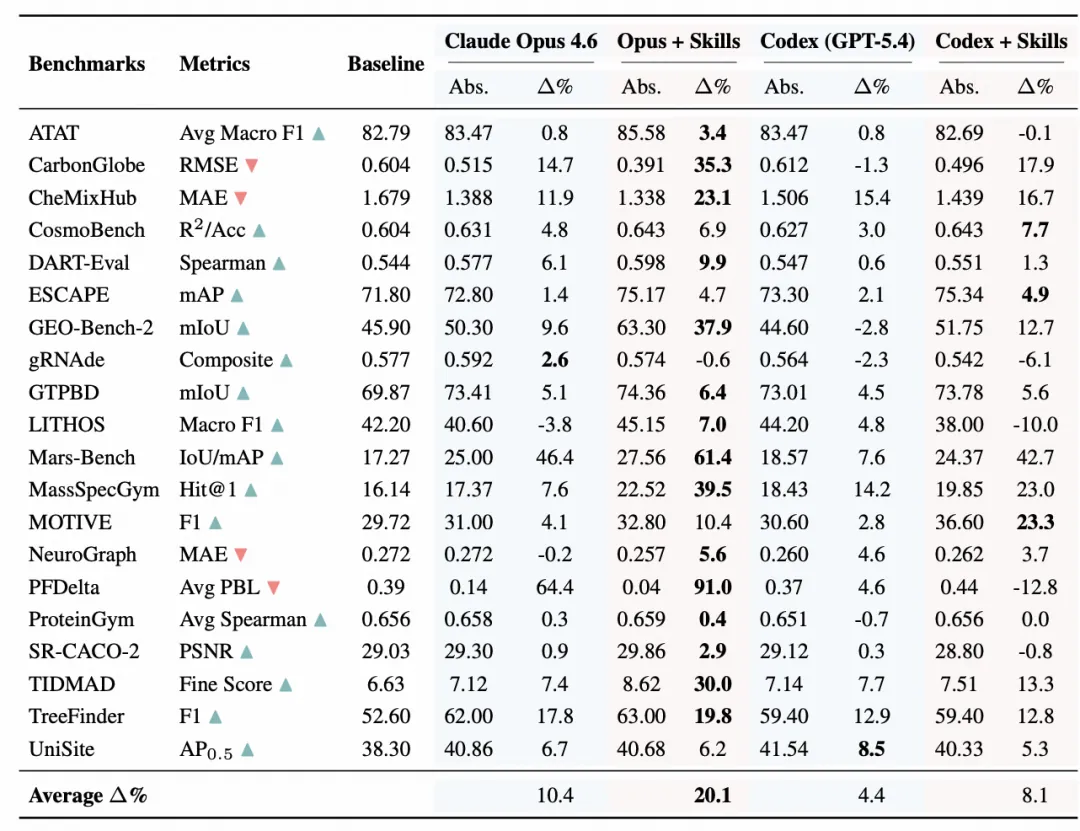
該公司提出Agent4Sci,一個面向科學機器學習任務的長程自動爬坡評測框架,覆蓋11個科學領域、20個基準,用以量度Agent在真實科研場景中的持續表現。
與單一任務測試不同,長程爬坡設計要求Agent持續迭代改進,貼近真實研究流程,令結果更能反映其跨學科科研能力,而非僅在個別指標上的表現。
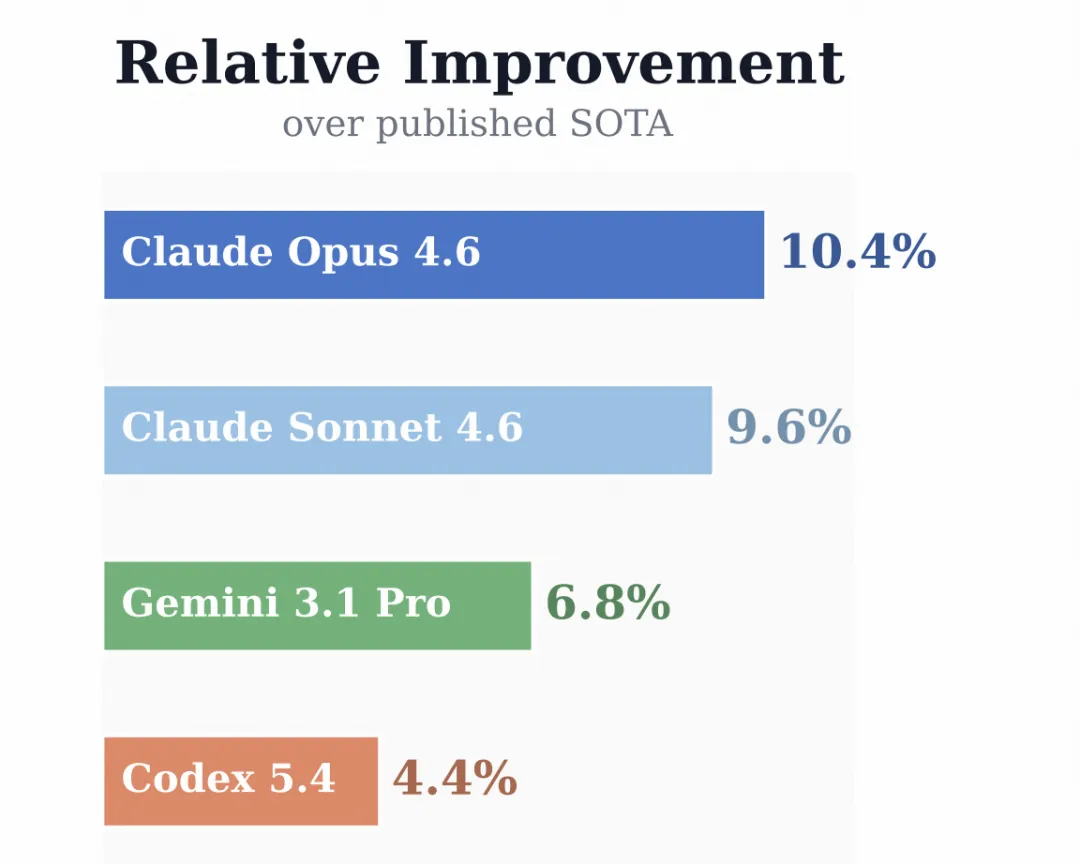
對科研自動化的意義
研究人員指出,缺乏標準評估的環境下,表面性能提升可能掩蓋真實缺陷;系統性框架有助分辨Agent是真正改進模型,還是僅利用評估漏洞。
此類框架為跨學科科研自動化提供可比較的基準,有助業界與學界評估Agent在非結構化環境中的實際能力。