IXThinker·2026-10-26 06:40
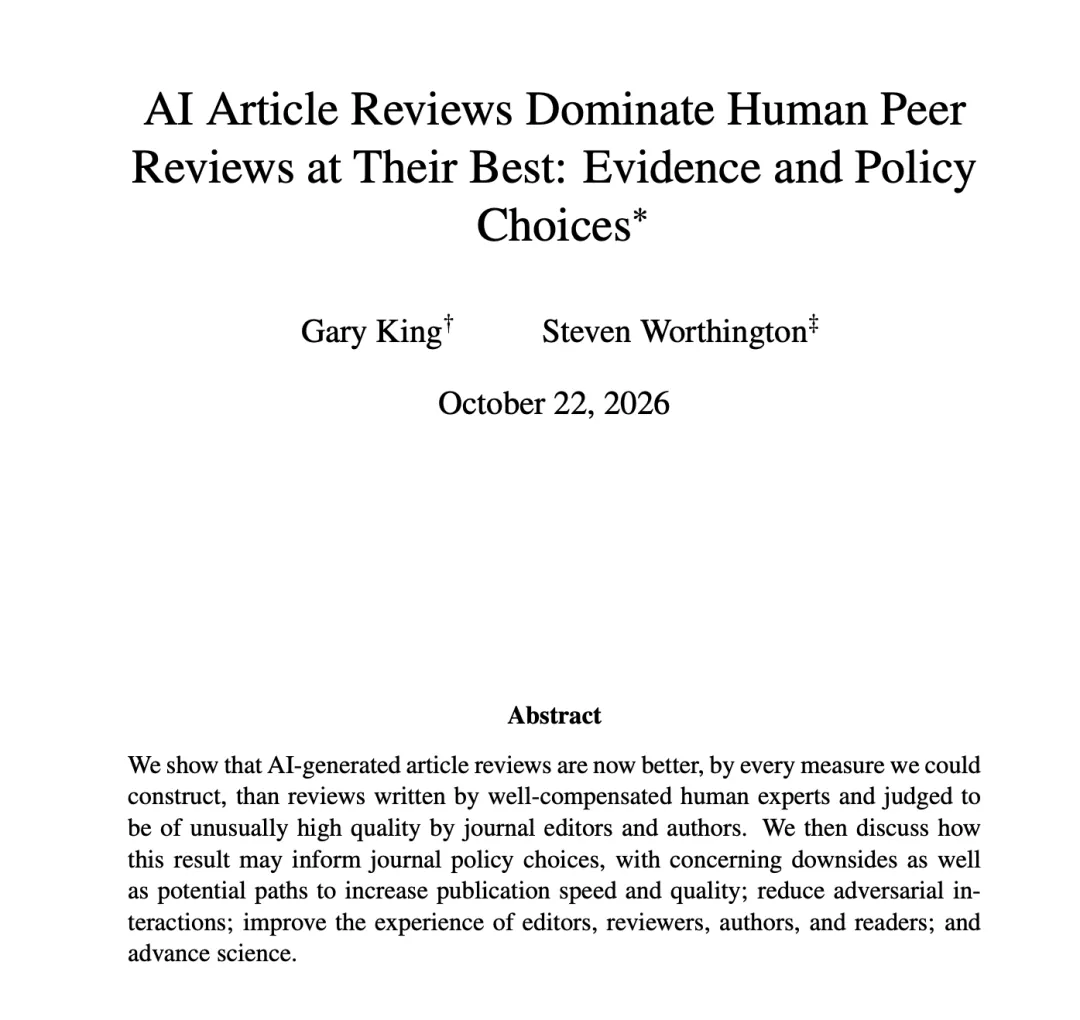
哈佛研究:AI審稿意見多項指標勝人類專家
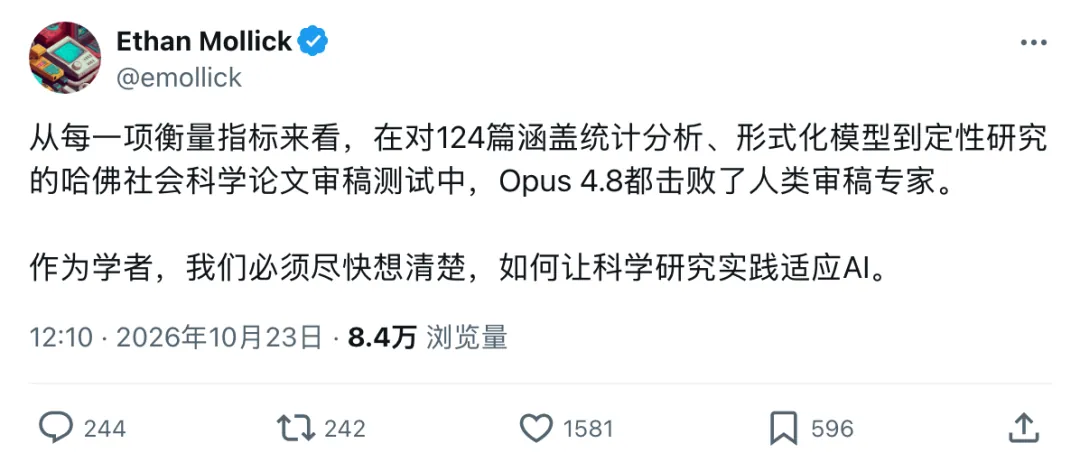
哈佛一項研究安排人工智能與人類專家審閱同一批124篇學術論文,並逐項比較審稿意見的質素。結果顯示,模型在七個評審維度全部領先,資深期刊編輯的盲選亦大多傾向模型,而人類意見的事實錯誤比例更高。
研究設計
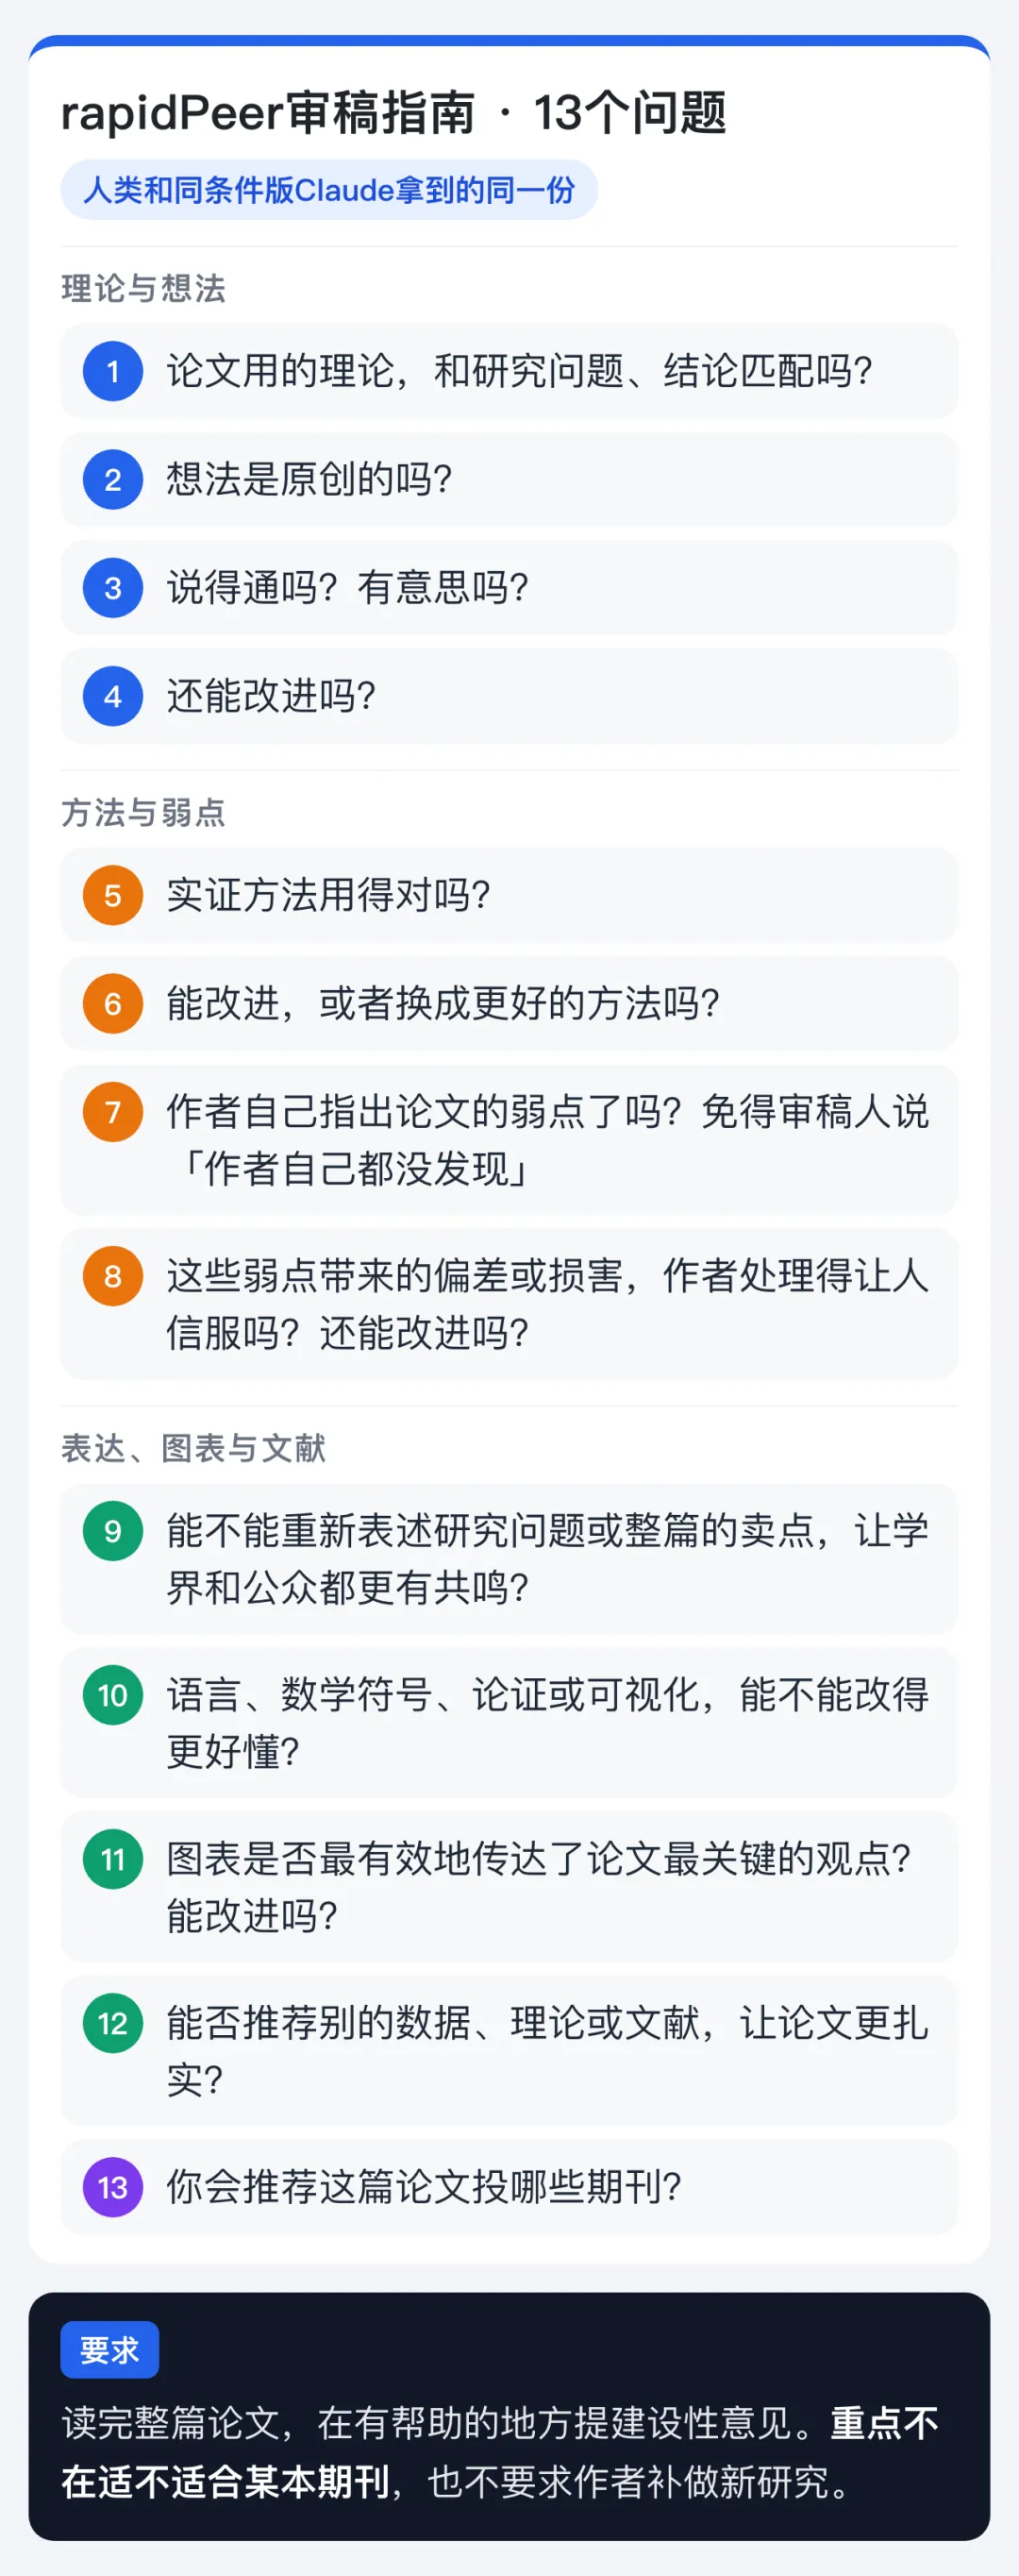
研究由哈佛大學校級教授、定量社會科學研究所所長Gary King等人進行,以同一批124篇論文為對象,分別由人工智能模型與人類審稿人撰寫審稿意見,再從七個審稿維度比較表現。
是次比較以同一批論文為基礎,雙方各自獨立撰寫意見,其後以相同標準量度。結果顯示,人類審稿人在七個維度中全數落後,未在任何一項取得優勢。
編輯盲選
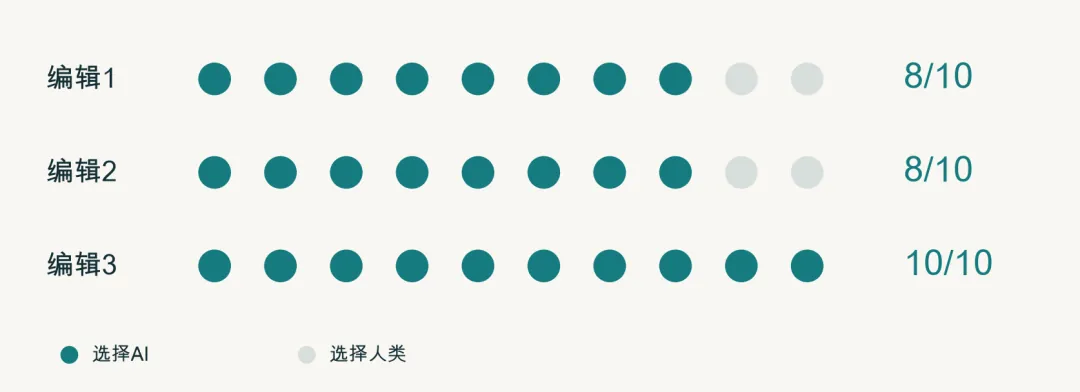
三位知名期刊前編輯獲邀參與盲選,每人比較十組匿名審稿意見,只閱讀意見本身,不重讀論文原稿。三十次盲選之中,二十六次選擇了模型的意見,其中一位編輯十組全數選擇模型。
盲選過程只提供審稿意見文本,不附論文原稿,以免影響判斷。在三十組配對之中,人類撰寫的意見僅四次獲選,其餘均由模型意見勝出。
準確性核實
研究人員亦檢驗意見的準確性,把雙方審稿意見逐句對照論文原稿核實,發現人類專家說錯的比例接近模型的三倍,模型的意見未見虛構內容。
在學術場景,意見是否與原稿相符是審核重點之一。是次核實以論文原文為依據,檢查雙方意見中的各項陳述是否有據,再統計兩邊出錯次數並換算為錯誤比例。