IXThinker·2026-10-26 18:30
聖地牙哥博士論文提出三途徑突破語言模仿限制
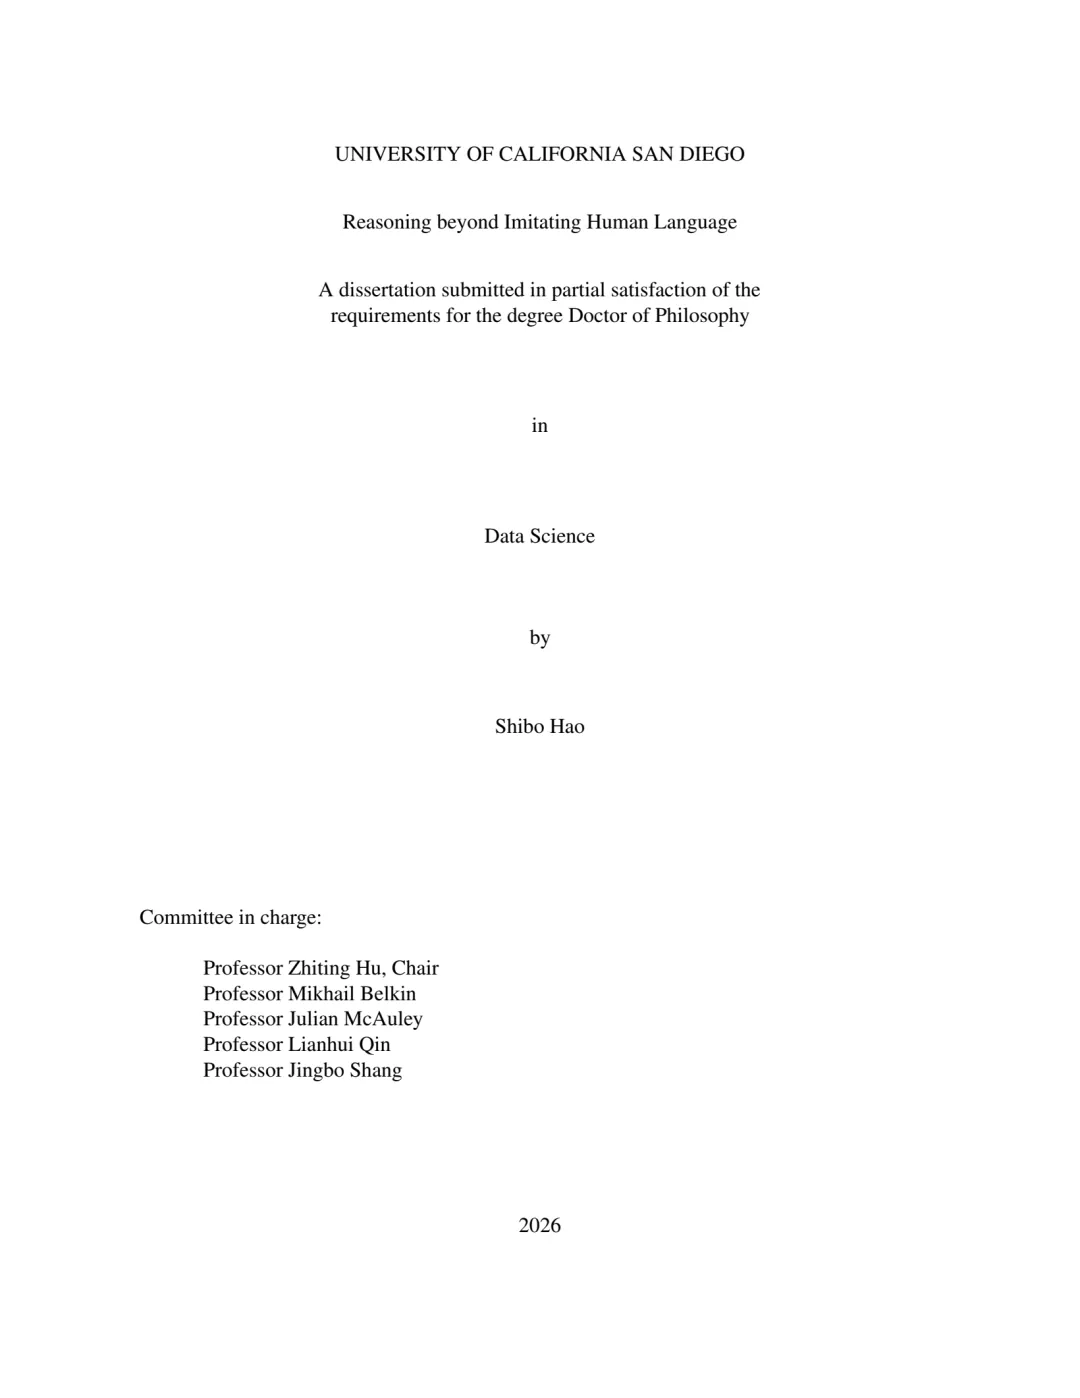
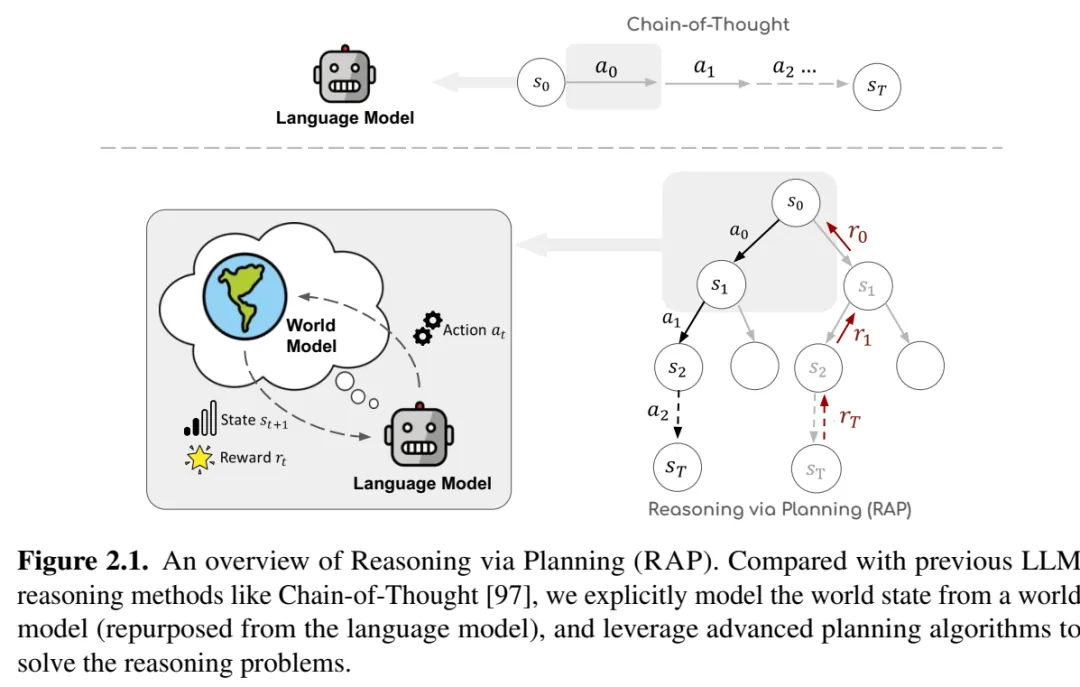
加州大學聖地牙哥分校2026年一篇博士論文探討大型語言模型的推理限制:模型學習的是模仿人類推理的結果,而非推理過程本身。論文提出三種突破語言模仿限制的方法,第一種將推理重新定義為規劃問題,讓語言模型同時擔任推理主體及世界模型。
論文核心問題
大型語言模型通過學習海量人類文本取得顯著進展,能夠生成流暢、符合語境的語言。然而這種訓練範式帶來根本限制:模型學習的是模仿人類推理的結果,例如文本記錄,而非推理本身的認知過程。
論文指出,這種以模仿結果為目標的學習方式,令模型與人類認知過程之間存在關鍵差異,亦成為推理能力受限的根源,是整項研究展開討論的起點。
能力短板
正因如此,大型語言模型在需要結構化探索、基於語境的符號計算,或深思熟慮的長線規劃等類型的任務上,始終面對明顯的能力挑戰,表現不如語言生成任務穩定。
這些能力在人類身上部分地獨立於語言之外運作,屬語言模仿路線難以直接覆蓋的範圍,亦因此成為這篇論文嘗試突破及補足的重點方向。
基於規劃的推理
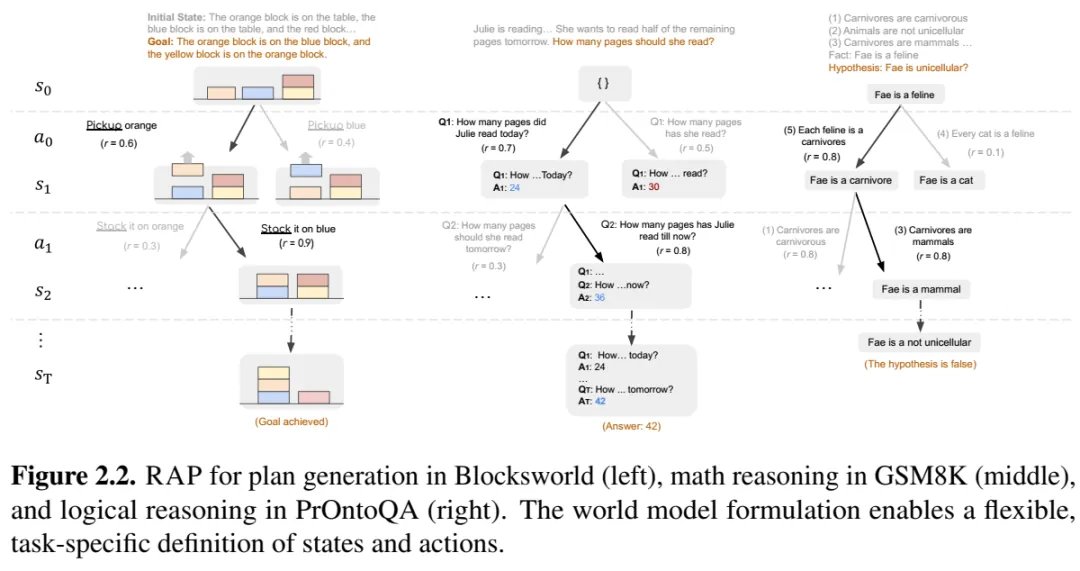
論文合共探討三種突破語言模仿限制的方法。第一種將LLM推理重新定義為規劃問題:「基於規劃的推理」(RAP)把同一語言模型同時用作推理主體及世界模型。
在這一框架下,模型通過蒙地卡羅樹搜索對推理空間展開系統探索,令推理過程具備搜索與評估的結構,而不是單純地逐字生成輸出文本。
研究目標
這篇論文的整體目標,是彌補大型語言模型在非語言認知能力上的根本缺陷,推動模型從單純的文本擬合,逐步邁向更接近真實推理的運作方式。
三種方法從不同角度切入同一項限制,其中以規劃為本的方法設有明確的運作框架;其餘兩種方法的具體細節,則有待查閱論文全文了解。