IXThinker·2026-10-28 16:50
CLaC模型對齊晶體結構與自然語言表述
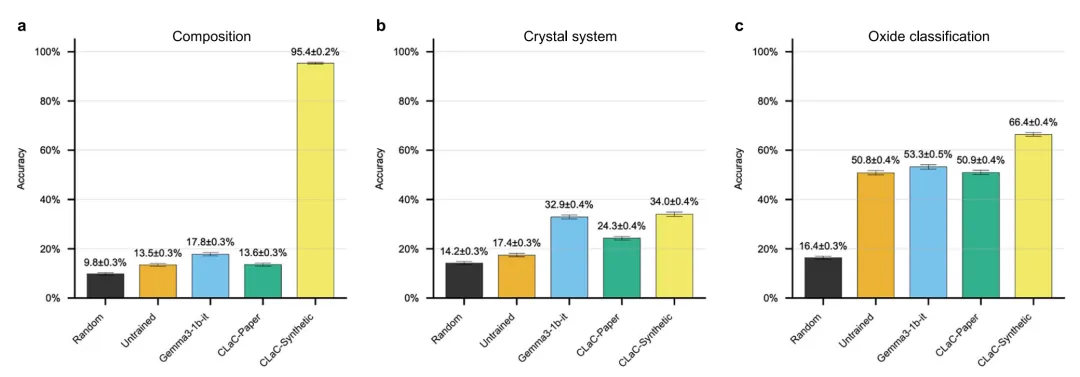
麻省理工學院等多機構研究人員提出對比語言—晶體模型CLaC,通過大語言模型生成材料屬性敘述,並以對比學習把晶體結構與自然語言映射到共享表徵空間,據稱零樣本識別準確率達95.4%。
合作機構
該研究由麻省理工學院、韓國蔚山科學技術院、伊利諾伊大學厄巴納-香檳分校及MIT-IBM Watson AI Lab等機構的研究人員合作完成,成果為對比語言—晶體模型CLaC,聚焦材料發現任務。
方法設計
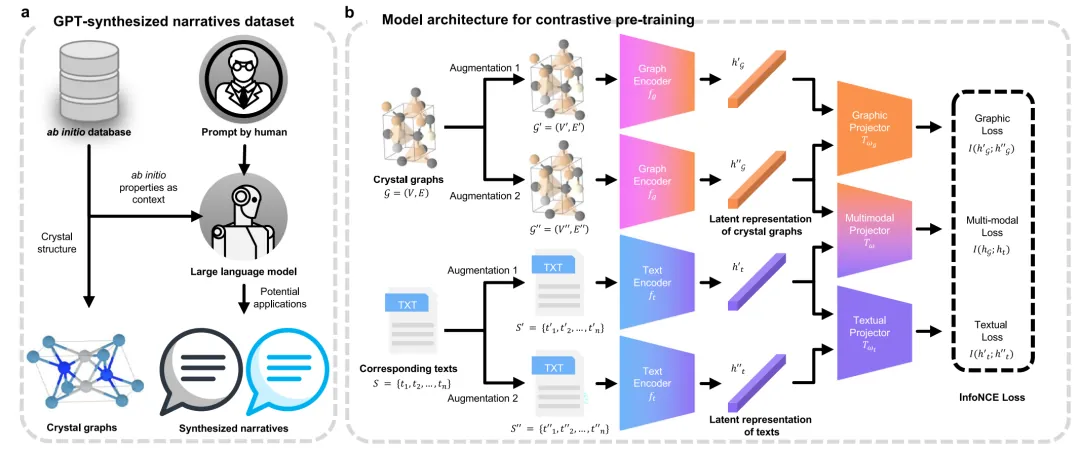
模型利用大語言模型生成以材料屬性為依據的合成敘述,再通過對比學習把晶體結構與自然語言映射到共享表徵空間,實現結構與語言兩種模態之間的對齊,令模型能夠理解以文字表述的材料需求。
材料發現難題
材料發現的一項重要任務,是從龐大的化學與結構空間中篩選具目標性能的候選材料。近年圖神經網絡通過學習晶體三維原子結構,在材料屬性預測與結構生成等任務上取得顯著進展。
模態斷層與回應
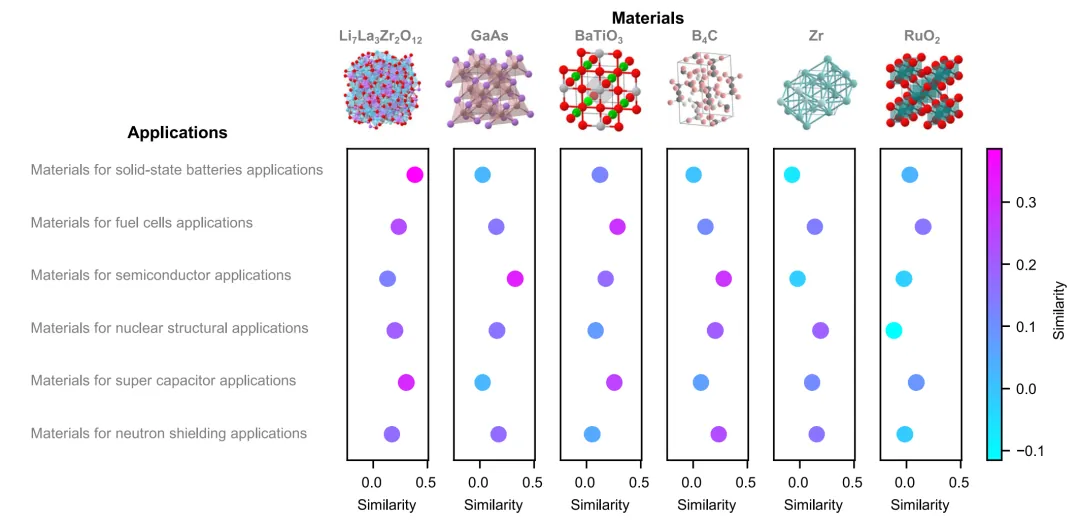
不過,圖神經網絡通常依賴預定義的屬性標籤或數值條件,難以直接理解自然語言描述的材料需求;大語言模型擅長處理文本,卻較難直接處理晶體結構。CLaC嘗試補足這一斷層,據稱零樣本識別準確率達95.4%。