IXThinker·2026-10-28 16:40
1.3B參數開源解析模型躍居三項基準首位
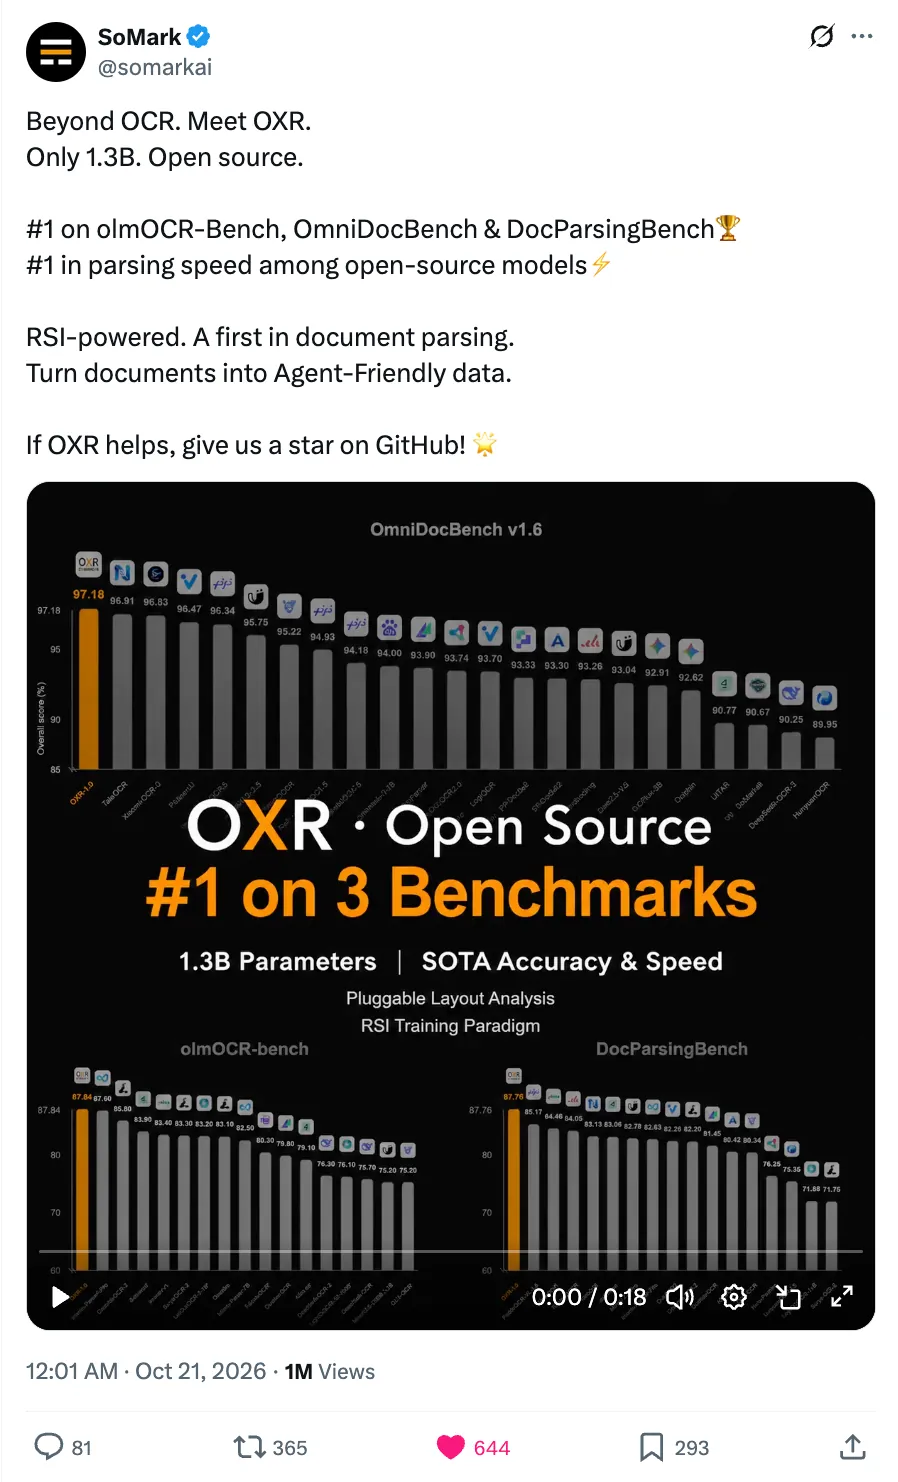
一款參數量僅1.3B的國產開源文檔解析模型,在OmniDocBench、olmOCR-Bench與DocParsingBench三項基準均位列第一,並展現把手寫筆記、化學結構圖等複雜內容轉為結構化輸出的能力。
三項基準奪冠
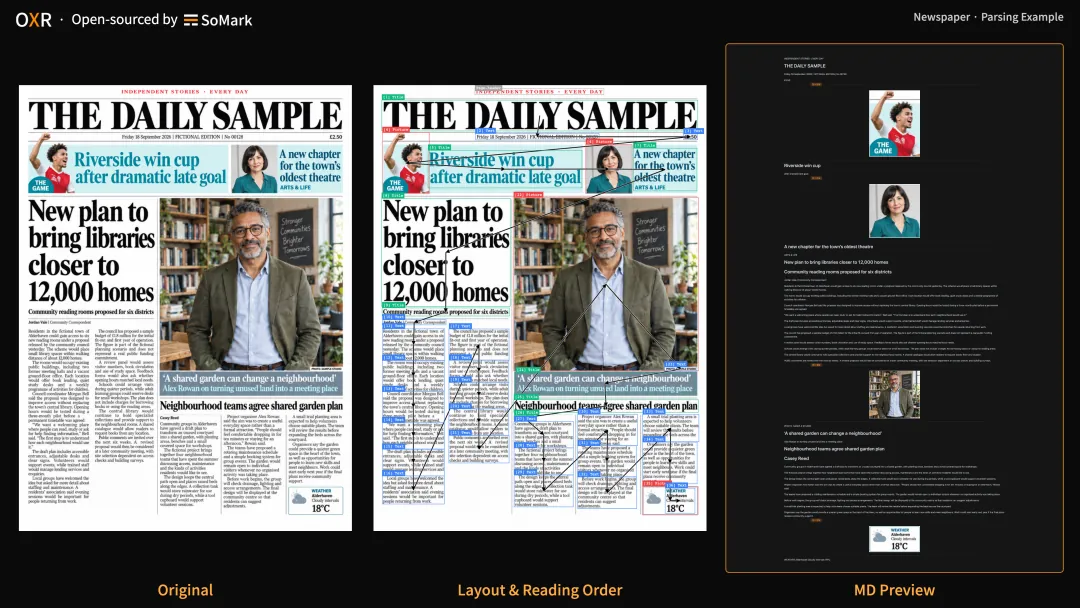
該模型在OmniDocBench、olmOCR-Bench與DocParsingBench三項文檔解析基準測試中均位列第一,覆蓋文本、公式、圖表等多類型內容,實現端到端的理解與結構化輸出,測試範圍相當全面。
複雜內容解析
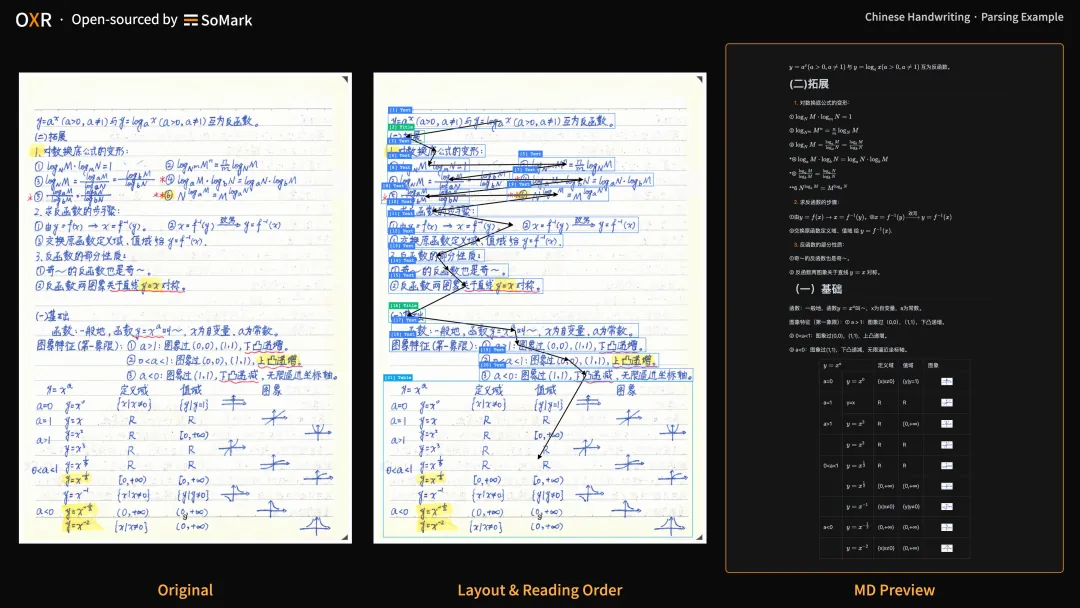
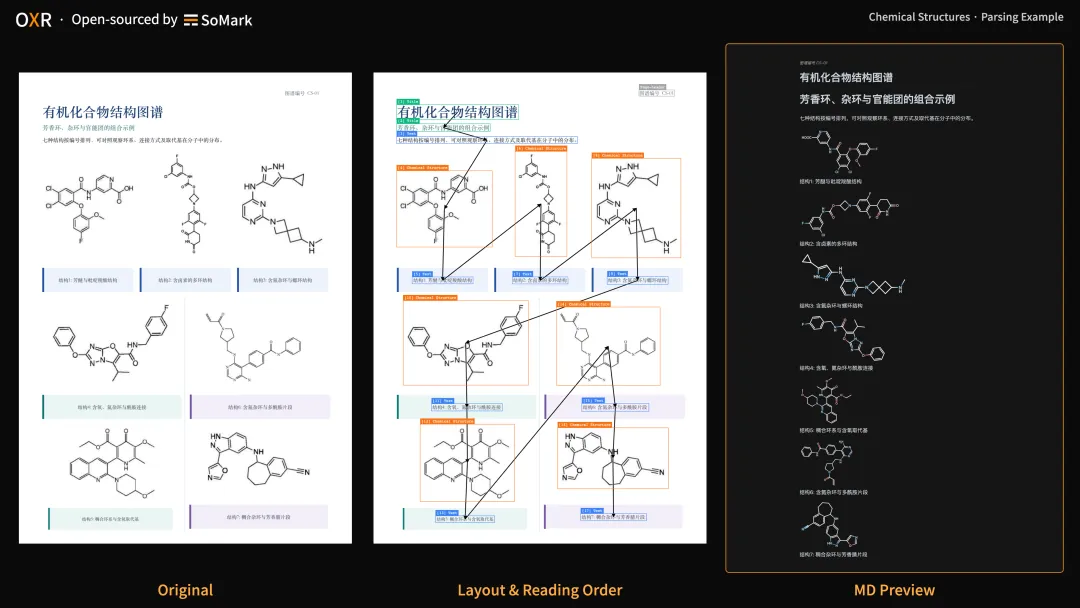
實際示例顯示,模型可把高等數學與古文手寫筆記一鍵轉為Markdown格式,亦能生成化學結構圖。對於手寫體、數學公式與圖形等複雜內容,模型的解析表現均較為穩定,覆蓋的場景相當廣泛。
解析速度表現
速度方面,在單張RTX PRO 6000上完成100頁端到端文檔解析,僅需約101秒。以1.3B的小參數量達到這一表現,令該模型在海外開發者群體中獲得不少關注,部署門檻亦相對較低。
文檔解析應用
文檔解析是把紙本或電子文檔轉為可檢索結構化數據的技術,廣泛用於書籍數字化、論文整理與資料歸檔等場景。該模型的表現顯示,輕量開源模型同樣可以在該領域達到頂尖水平,為相關應用提供新選擇。