IXThinker·2026-10-28 12:10
百度開源OCR模型長文檔解析居榜首
百度時隔四個月再度開源新一代文檔解析模型文心Unlimited OCR 2。該模型總參數30億、推理時僅激活5億,在兩項長文檔解析基準取得第一,前代累計下載量超過1,000萬次。
輕量架構設計
文心Unlimited OCR 2總參數為3B,每次推理實際激活僅500M(5億),延續該系列輕量高效的設計思路。推理時只激活部分參數的方式,令小體量模型得以承載更大的參數儲備,在能力與開銷之間取得平衡。
兩項基準第一
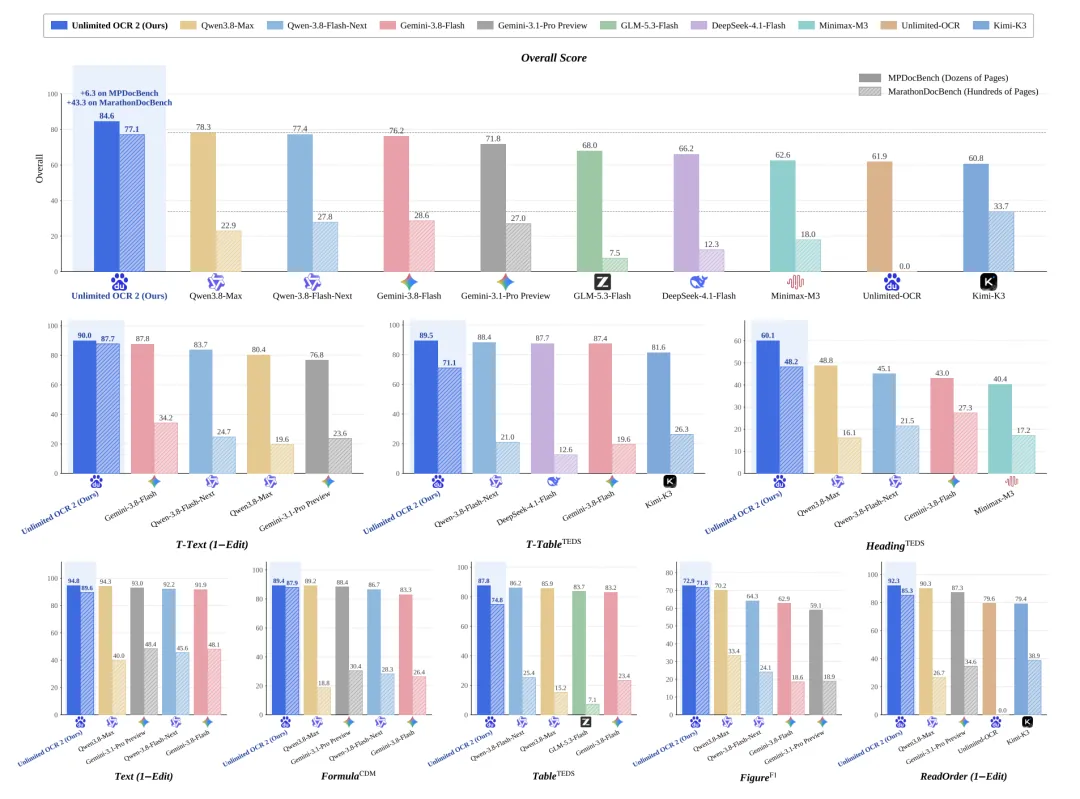
在百頁級長文檔基準MarathonDocBench(103至300頁)中,該模型取得77.06分位列第一;在多頁跨頁基準MPDocBench取得84.59分,位居榜首。兩項基準均針對長文檔與多頁文檔的解析難度而設計。
長文檔解析示例
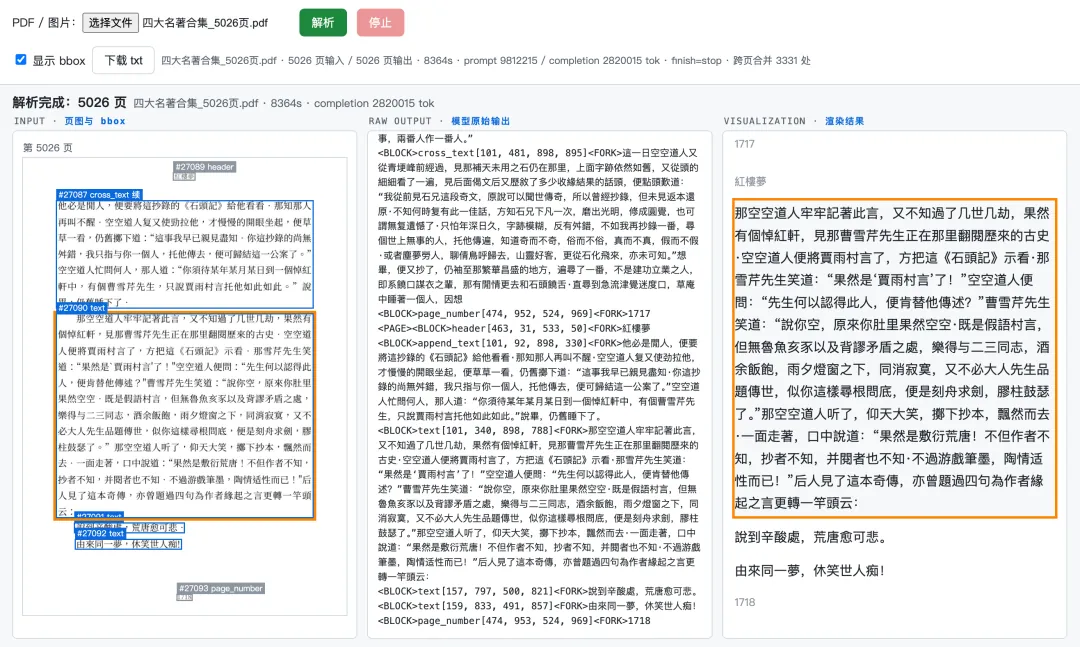
官方示範把《哈利·波特》七部曲合共3,600頁的內容交由模型解析,展示其在超長文檔場景下的處理能力。長文檔任務對上下文記憶與前後一致性要求較高,歷來是文檔解析技術的難點所在。
前代累積聲量
該系列前代曾獲LeCun轉發,累計下載量超過1,000萬次。時隔四個月推出升級版本,顯示百度持續在工業級文檔理解方向推進開源布局,以輕量高效的路線爭取更廣泛的應用落地。