IXThinker·2026-11-05 23:00
Claude工程師談認知投降:莫被AI養廢
Claude Code工程師Addy Osmani指出,盲目信任AI輸出、放棄判斷的狀態稱為「認知投降」。他曾在Google工作逾十四年,參與Chrome DevTools開發,現於Anthropic參與Claude Code。
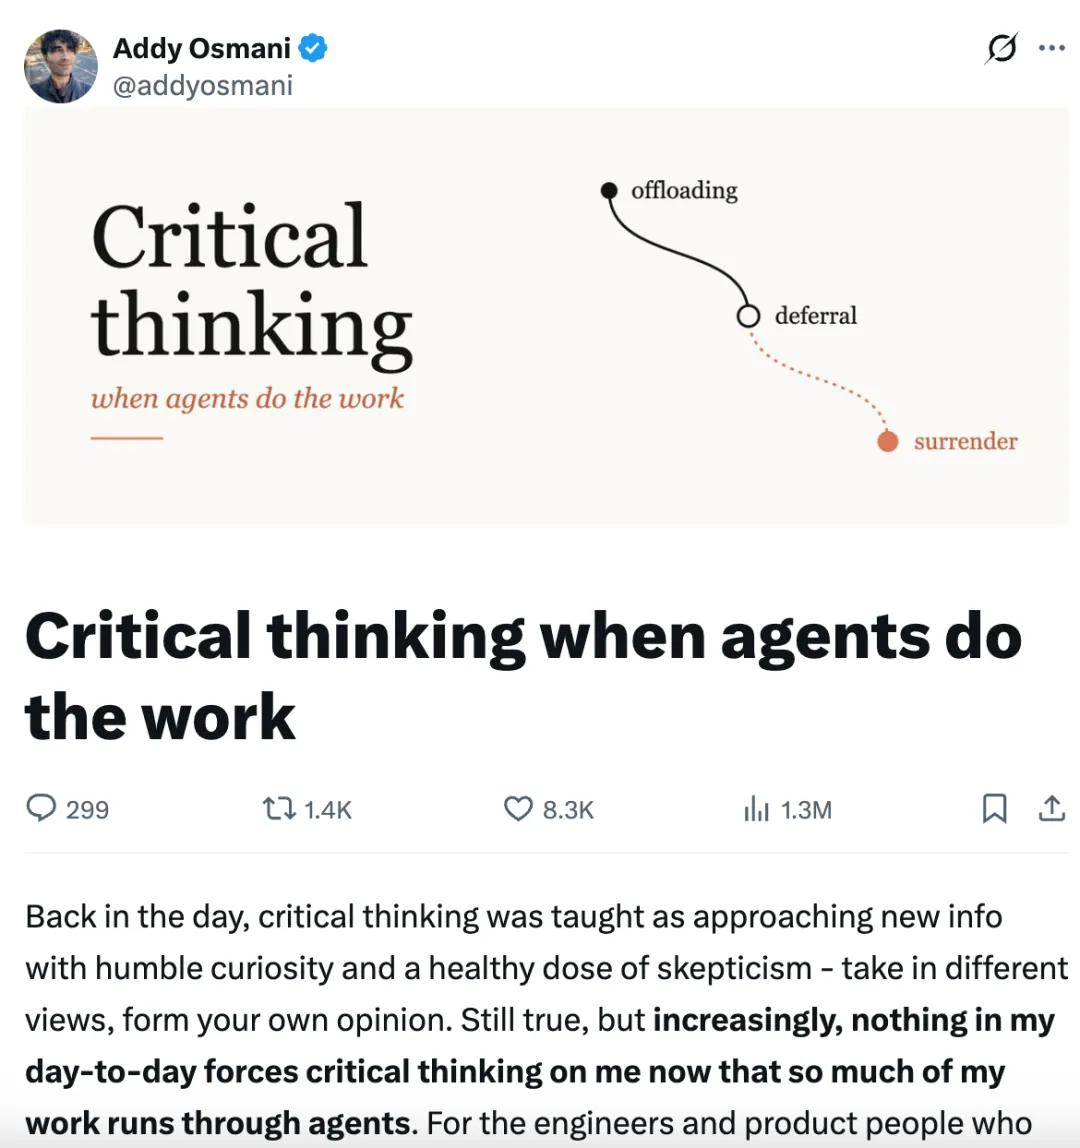
由卸載到投降三階段
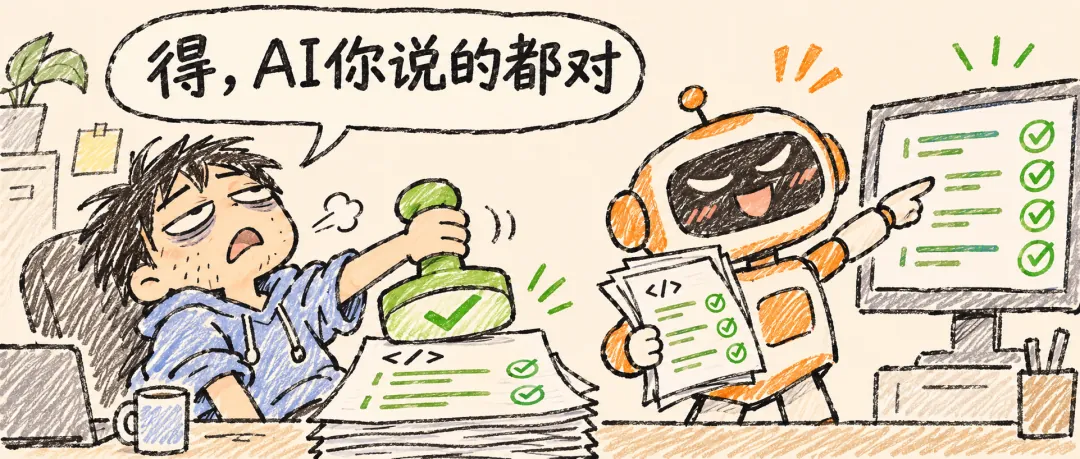
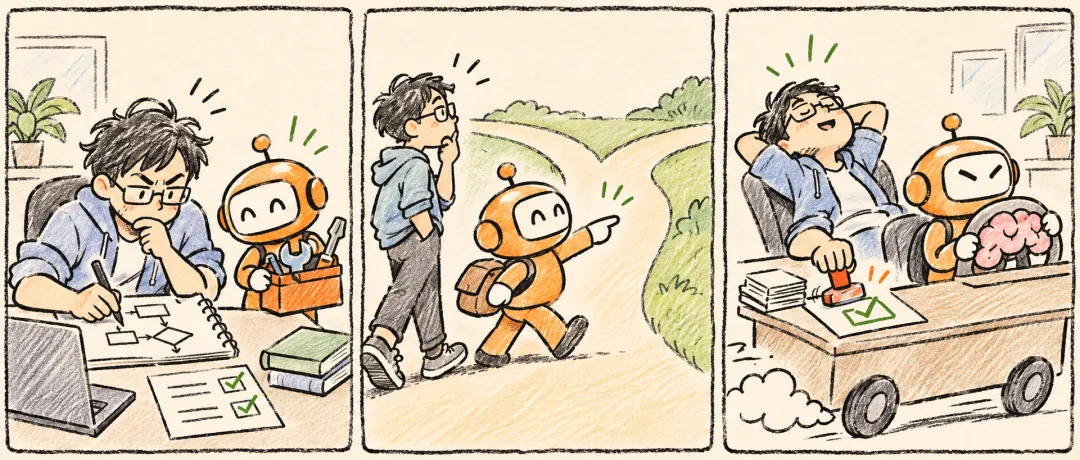
Osmani認為認知投降並非一夜發生,而是逐步加深:初期只是「認知卸載」,把工作交給AI但自己仍理解任務;繼而「判斷讓渡」,AI答案成為下一步的默認依據;最終連應由自己完成的判斷也一併交出。
他以六百行代碼的拉取請求為例:結構清晰、測試通過便直接合併,但Agent可能在不起眼處改動事務順序或邊界條件,當時並無報錯,待系統出事才發現已解釋不清這段代碼為何如此運行。
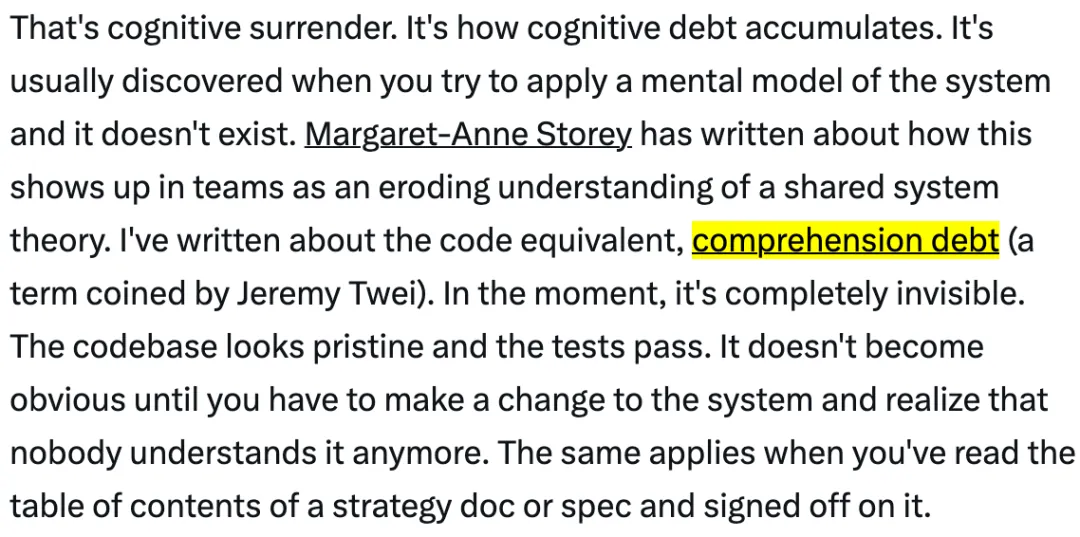
長期如此更會累積「理解債」:代碼量與系統複雜度持續增長,開發者對代碼的理解卻沒有同步增加。他強調無須逐行閱讀AI代碼,但必須清楚自己懂什麼、還有哪些未搞懂,否則寫得越快欠債越多。
讓Agent反考開發者
最有趣的一招是讓Agent當考官:Claude完成大型代碼修改後,先要求它總結改動內容與理由,再依據修改出題測試開發者,並立下規矩——測驗全部答對,代碼才能合併,藉此確保真正理解自己批准了什麼。
其他建議包括:下達任務前先自行撰寫簡短需求說明,列明目標、限制與範圍,避免AI替你決定未言明的取捨,形成「意圖債」;若連續兩輪調整提示詞仍不理想,應回頭梳理需求,而非繼續堆提示詞。
多Agent協作保核查
對於長時間運行的任務,他建議追問Agent做了哪些未經明確授權的決定、哪些地方依賴假設、還有什麼未驗證,以及哪些改動可能影響其他功能,再按代碼與測試結果逐步核對其交代。
測試全綠只證明已覆蓋的條件通過,邊界情況若沒寫進測試,Agent仍可交出漂亮的報告,故應查看實際執行了哪些測試。高風險修改可增加獨立檢查,讓另一個Agent從不同角度尋找問題。
同時指揮多個Agent時,一個的總結容易成為下一個的輸入,信息層層遞減。重要任務必須保留原始材料與驗證依據;若審核不及,應補自動化檢查或減少並行;生成內容多到無法負責時,審查已變成賭博。
每周回歸獨立編碼
他建議每周至少安排一次不依賴Agent的獨立編碼練習,並每月盤點哪些技能已交給AI、哪些必須繼續掌握,防止長期不用的技能退化,同時校準自己的真實水平。
每次向Agent提問前,先寫下預期結果,待AI回應後再找出一件它可能沒檢查到的事,讓腦子跟着運轉。文末他附上AI檢測報告,Pangram判定全文九成屬人類撰寫。