IXThinker·2026-11-05 18:50
LoLBench實測28種Agent組合
復旦大學、香港城市大學、香港中文大學等機構推出代碼基準LoLBench,從真實功能提案及對應已合併PR中選出100項任務,覆蓋29個系統、8種語言與5個領域,檢驗Agent能否從需求出發,在大型軟件系統內完成跨模組的完整交付。
任務規模遠超現有基準
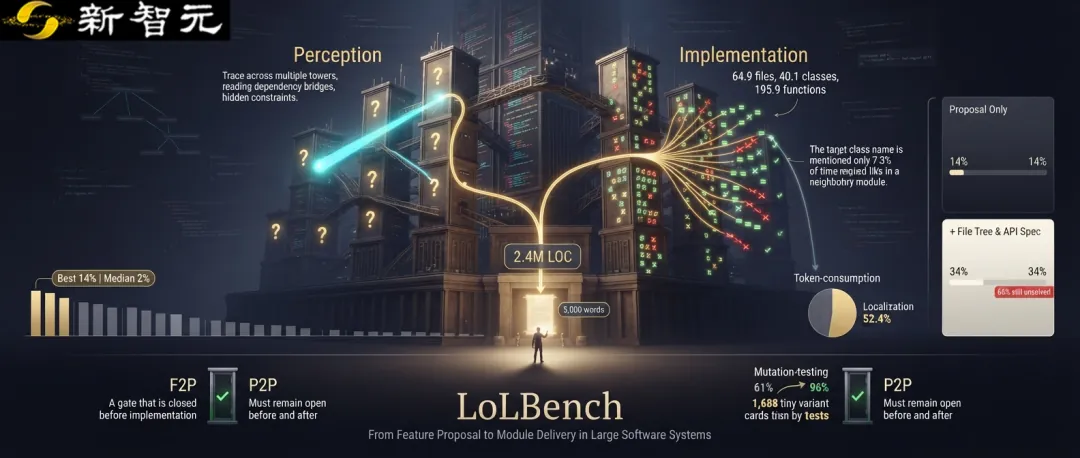
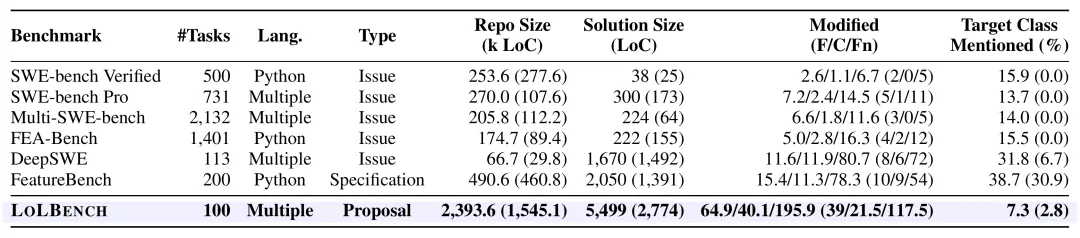
任務取自社區功能提案,平均約5000個英文單詞,評測在斷網的Docker環境進行,防止Agent檢索上游實現。倉庫平均約240萬行代碼,是SWE-bench Verified的9.4倍;每項任務平均改動5499行、64.9個文件與195.9個函數,遠超局部Bug修復型任務。
感知與實現兩重難關
挑戰分兩類:感知複雜性指讀懂提案、識別隱含約束與跨模組依賴、推導修改範圍的難度;實現複雜性指把規範轉為正確的跨文件修改,並通過測試避免破壞既有功能。參考實現的目標類名在提案中的平均提及率僅7.3%,不及SWE-bench Verified的15.9%一半。
測試體系經過強化
驗證分兩類測試:新增功能測試要求實現前失敗、實現後通過,並按公開接口檢驗行為,允許不同內部實現;回歸測試要求前後均通過。團隊另構造遺漏功能、篡改需求等錯誤實現作為變異體,補充測試後1688個變異體的檢出率由約61%升至96%,按任務平均的行覆蓋率由約60%升至79%。
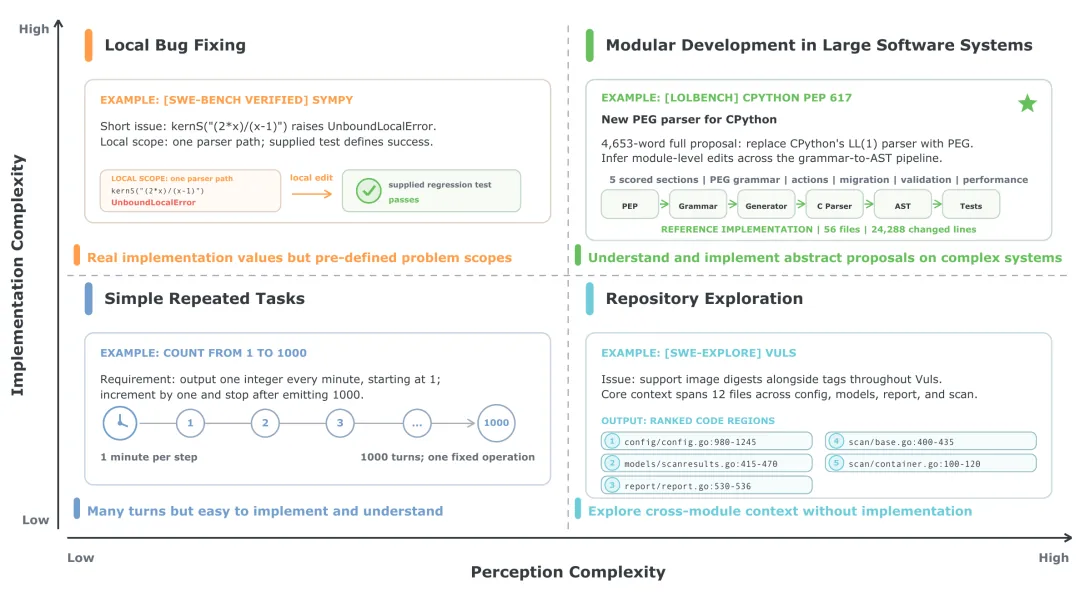
最強組合僅解決14%
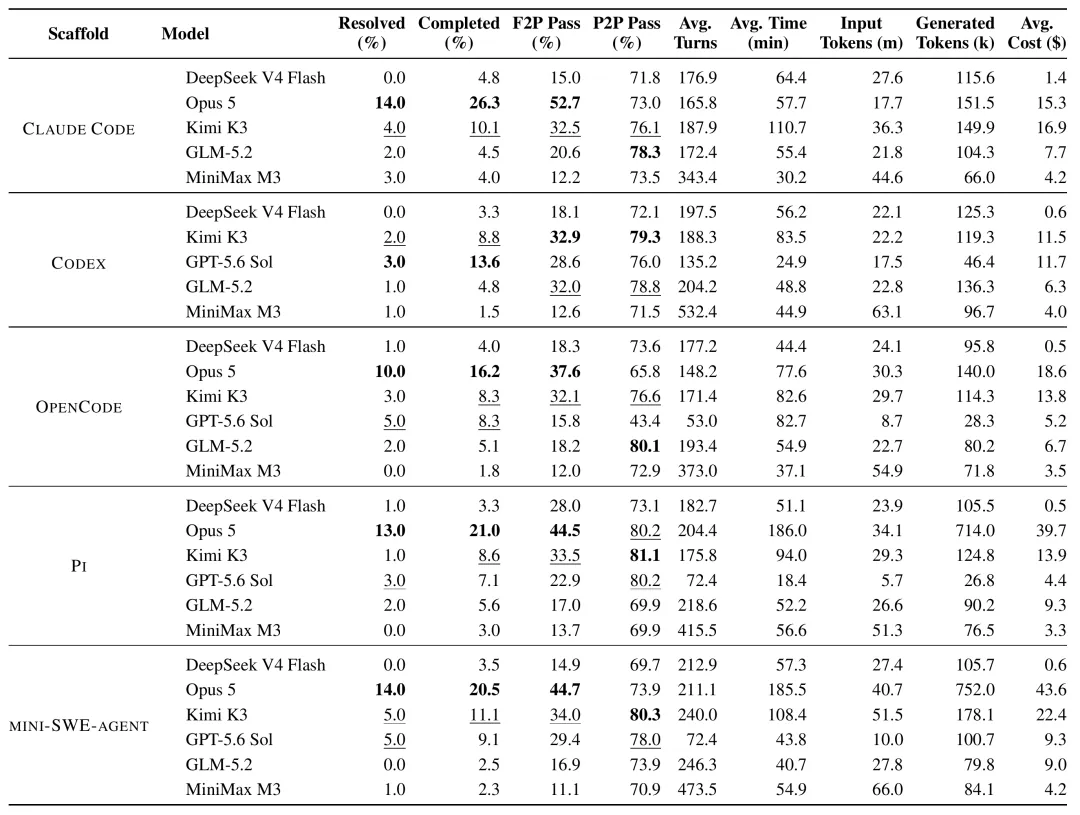
團隊評估6個前沿模型與5個腳手架的28個組合,單任務限時6小時。Opus 5搭配Claude Code或mini-SWE-agent均以14%並列最高,全部組合中位數僅2%。mini-SWE-agent與Claude Code同解決率,前者耗時3.2倍、token開銷5倍。
定位開銷與補充指引
按平均計,代碼定位階段佔非緩存輸入token的52.4%、生成token的45.4%,交互輪數亦明顯多於其他階段;文件修改精確率介乎38.0%至80.4%,召回率30.3%至65.0%,函數級召回最低僅20.8%,定位準確率與覆蓋仍不足。
保留原提案、額外提供參考實現的修改文件樹與API規範後,Opus 5加Claude Code的解決率由14%升至34%,GPT-5.6 Sol配Codex由3%升至25%,DeepSeek V4 Flash配OpenCode由1%升至17%;但最佳組合仍有66%任務未解決。