IXThinker·2026-11-05 17:50
清華聯合伯克利開源uni-robot-agent
清華大學丁寧、劉知遠、徐夢迪、周伯文等團隊聯合加州大學伯克利分校Pieter Abbeel團隊,開源統一機器人操作框架uni-robot-agent,連接模型與機器人環境並支持進一步訓練,讓開源權重模型在無特權輸入下展現具競爭力的操作能力。
回應開源RUA困局
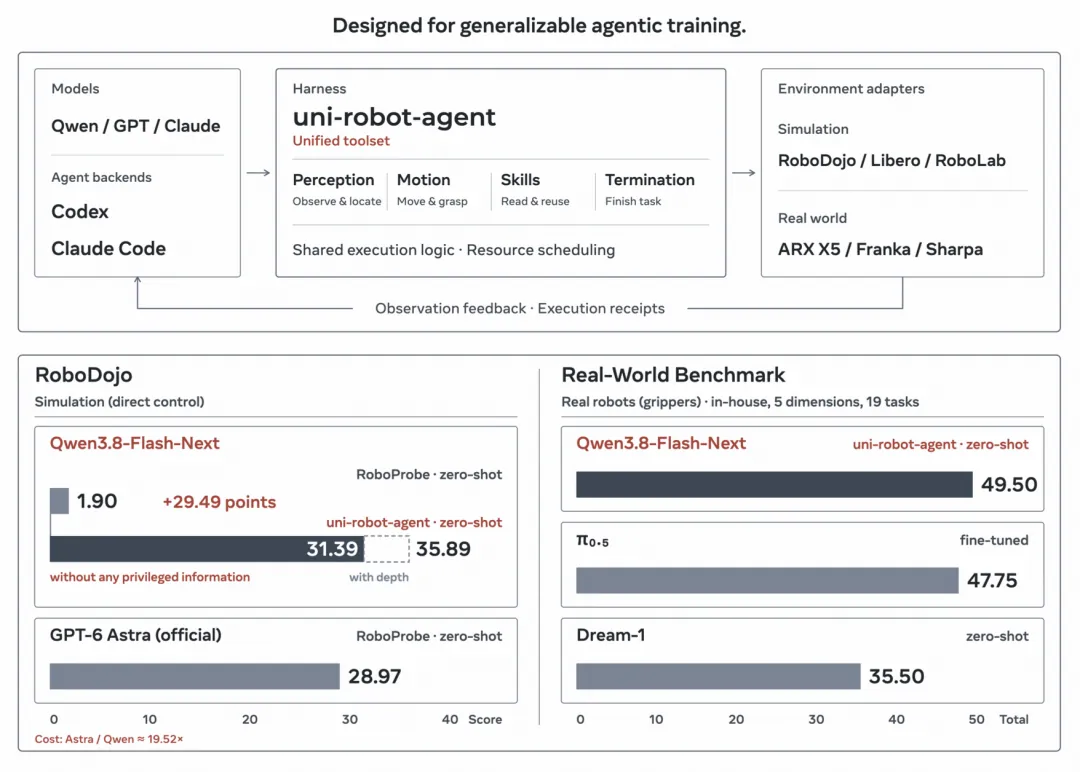
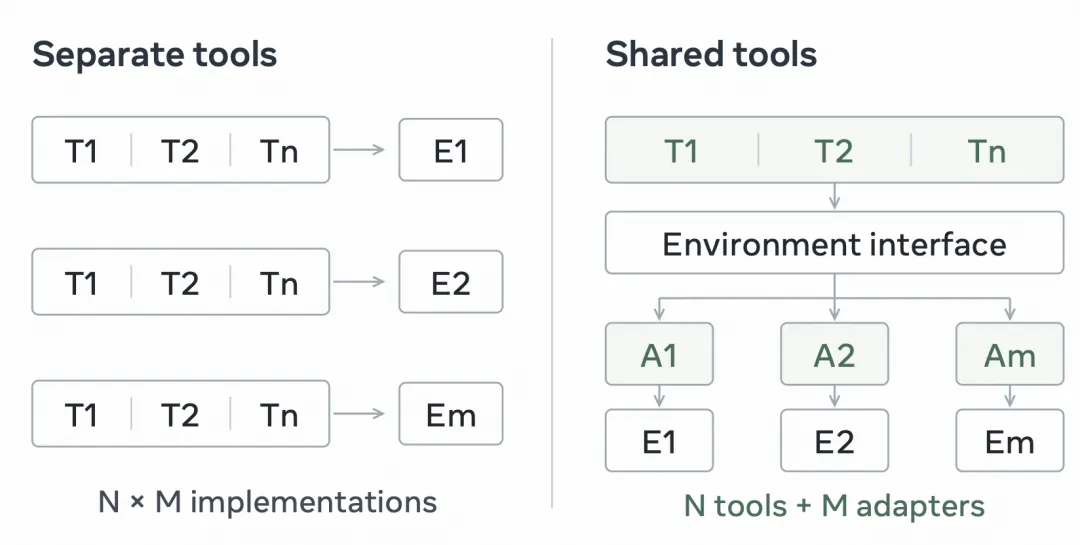
機器人使用智能體雖已展現可觀的零樣本操作能力,卻嚴重依賴前沿專有模型:研究人員拿不到權重,難以用真實操作經驗繼續訓練;API費用高昂且無法自行優化推理,大規模實驗難以開展。團隊遂先建立通用可靠的harness,統一不同模型、機器人形態、任務與環境的工具接口與反饋格式。
不靠特權輸入取勝
團隊的關鍵判斷是:機器人操作未必需要部署時無法獲得的信息。若一開始就提供模擬器真實狀態、直接告知任務成敗,或針對任務預寫技能,雖可提高成績,卻難以判斷通用能力的來源。團隊選擇只組織模型可用的真實環境信息,包括相機標定、機器人描述與能返回有效反饋的可靠工具接口。
流水線執行提升效率
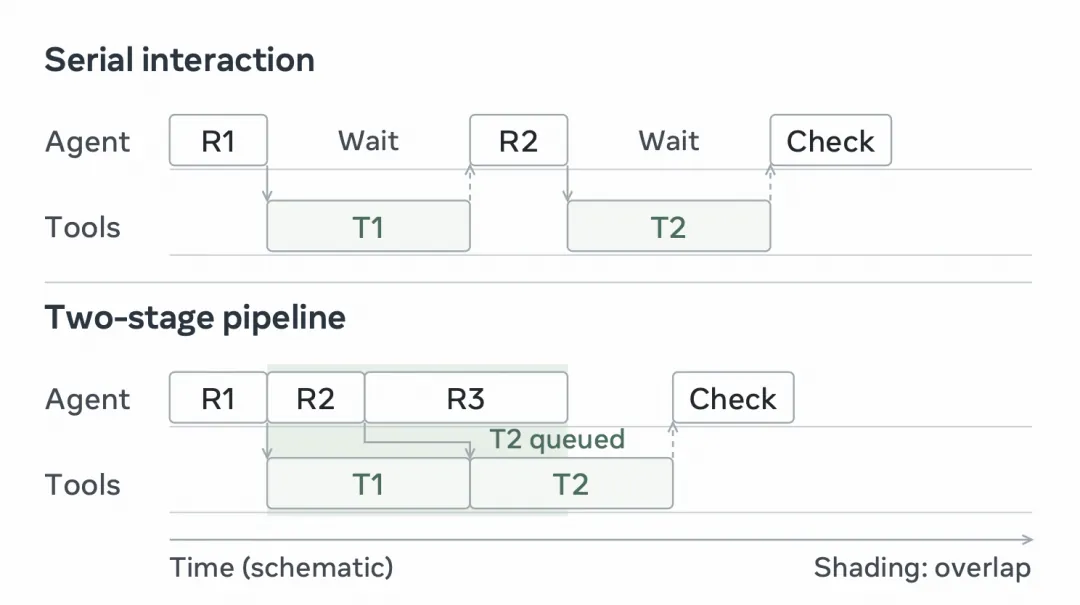
harness亦顧及交互效率:機器人執行動作時,模型推理可與工具執行重疊,減少依次等待的耗時;agent運行時、工具與機器人後端採用可替換設計,方便研究人員更換組件、比較方案。對需要持續收集機器人交互經驗的訓練研究,這些設計直接關係到系統能否擴展。
RoboDojo成績領先
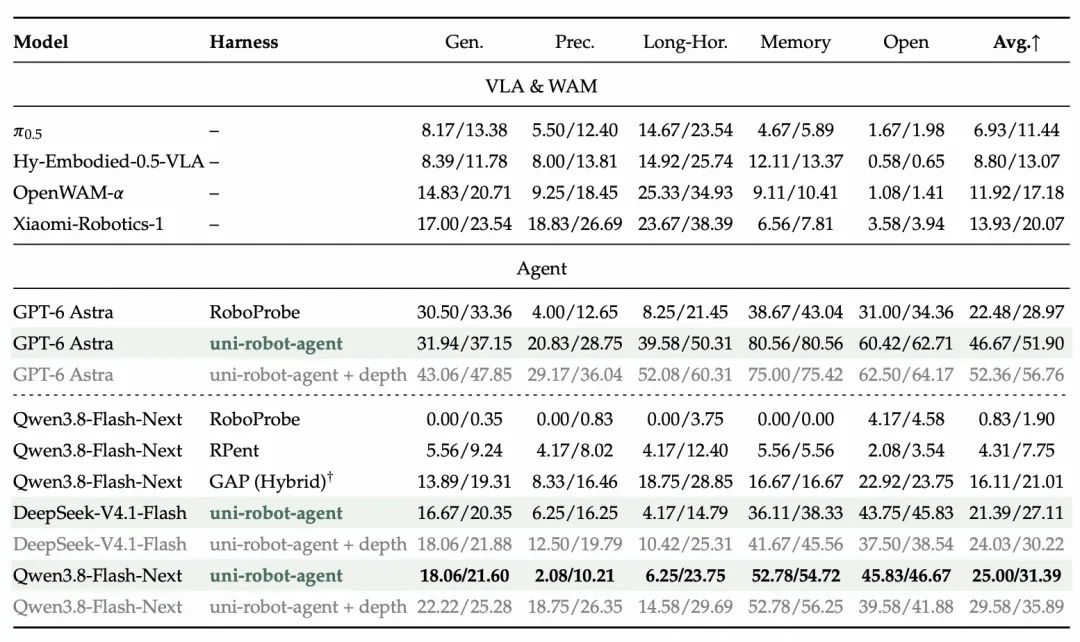
在RoboDojo上,未經機器人專項訓練的Qwen3.8-Flash-Next配合uni-robot-agent,在無特權輸入設置下取得31.39分,超越GPT-6 Astra配RoboProbe的28.97分,也勝過多個經任務微調的VLA與WAM基線。
團隊另在19項真實桌面操作任務中測試系統,表現概括為具競爭力,顯示統一交互方式可延伸至物理機器人。仿真與真實環境的共同測試,令研究關注的不只單一模擬器成績,也包括能否用於真實機器人。
失敗歸為四類能力
建立開放模型操作基線後,團隊比較不同代際、系列與規模的模型,並分析操作軌跡,將常見失敗歸納為視覺理解、空間定位、幾何編碼與具身推理四類,據此提出機器人操作能力或源於多種通用能力協同,未來訓練應推動其共同發展;惟系統現階段仍難處理精細操作與可靠的長程執行。