IXThinker·2026-11-06 17:30
淘寶MNN開源0.3B手機端模型
淘寶MNN團隊開源MNN-Pocket-0.3B,定位「手機應用原生大模型」,將模型結構、詞表、訓練方法與推理引擎協同優化。iPhone 18 Pro真機完全離線平均解碼約350 token/s,部署文件僅173MB。
手機原生設計目標
團隊將設計方向命名為「手機應用原生大模型」,訂下四項目標:指定設備與上下文下解碼吞吐超過200 token/s;峰值內存低於300MB;典型負載單次推理增量能耗不超過參考電池電量的萬分之一;任務效果以達8B級為目標,兼顧中英文理解、數學與代碼推理,並強化指令遵循。
動因在於資源競爭:淘寶、閑魚等高頻應用中,模型須與業務共享算力、內存和帶寬,還要在持續調用與多任務併發下兼顧時延、功耗和溫升,只完成加載與單次對話並不足夠。
真機效率對比
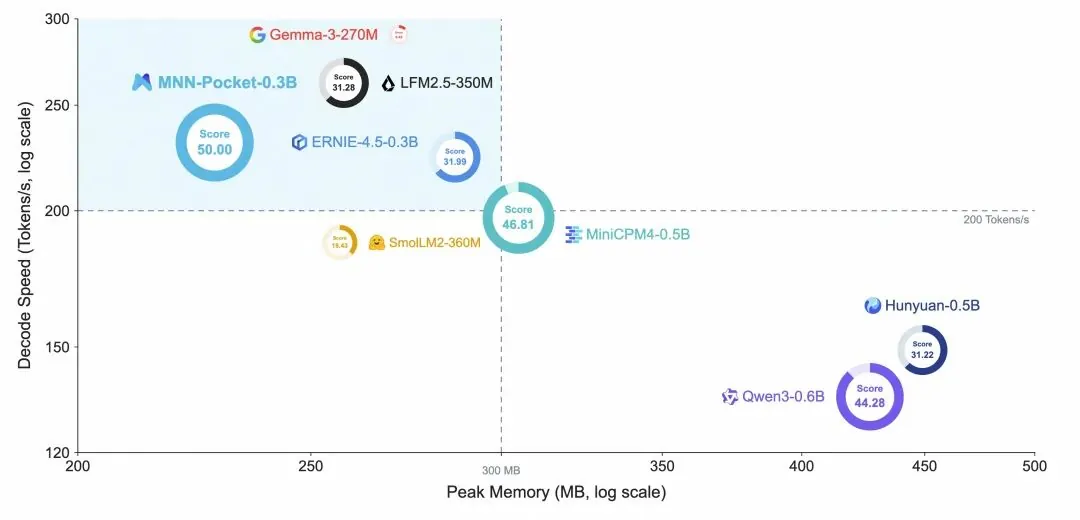
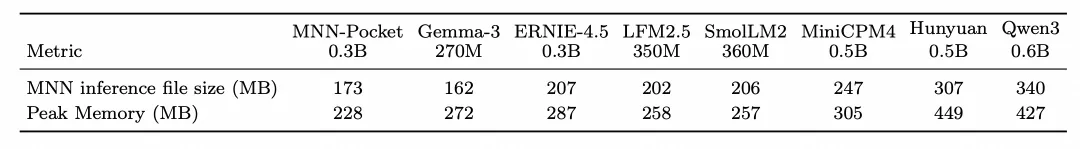
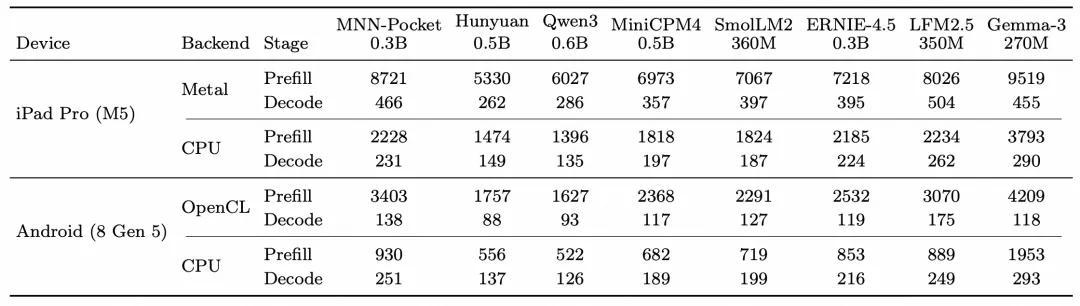
iPhone 18 Pro上模型經MNN引擎完全離線運行,平均解碼約350 token/s;INT4部署文件僅173MB。iPad Pro M5、512 token測試下峰值內存增228MB,較Qwen3-0.6B減約47%,部署體積亦小約49%。
速度上,iPad Pro M5 Metal後端512 token配置下Prefill吞吐8,721 token/s、解碼466 token/s,約為Qwen3-0.6B的1.63倍;Snapdragon 8 Gen 5 CPU後端解碼251 token/s。
結構與詞表取捨
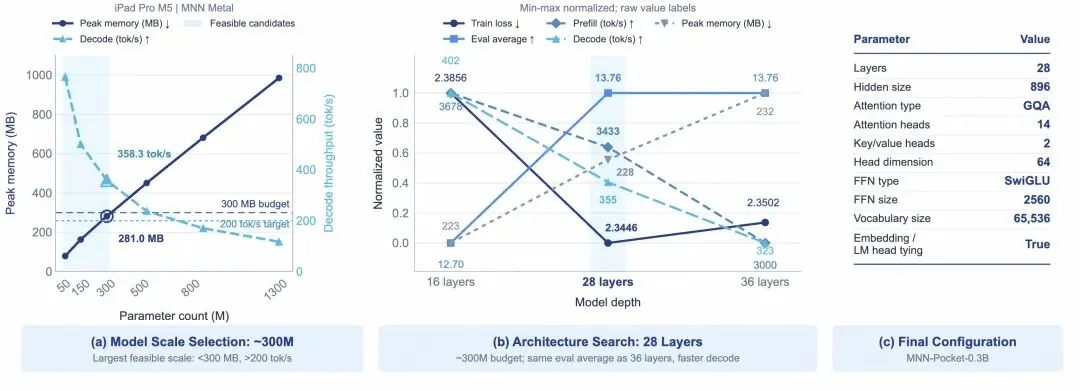
團隊以峰值內存低於300MB、解碼吞吐高於200 token/s為架構目標,在約50M至1.3B參數的稠密配置中選出約300M為同時滿足兩項約束的最大規模;層數由16增至28帶來提升,增至36層評分不再提高且吞吐由355降至323 token/s,最終採28層與GQA。
詞表方面,模型面向中文互聯網應用,基於Qwen3分詞器把約151K詞表精簡至64K,縮減約57%,降低詞嵌入與輸出層開銷;裁剪時保留特殊詞元與必要合併依賴,兼顧編碼效率避免序列變長。
推理引擎側,MNN在CPU為Arm指令定制低比特內核,GPU側優化緩存與計算分塊,並提供高通Hexagon專用後端;還支持8-draft配置的投機解碼,減少逐Token生成的串行開銷。
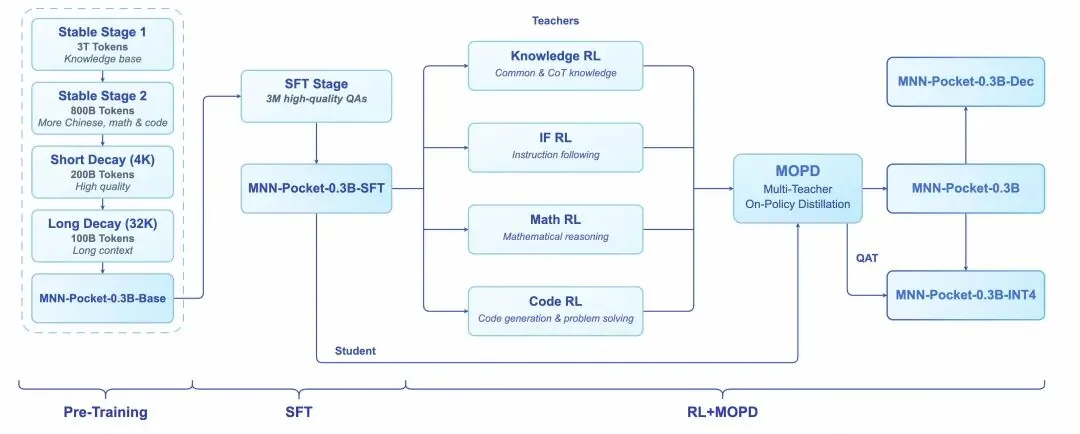
訓練與蒸餾管線
預訓練數據按質量、知識密度、難度等五維標注分級,約4.1T token分四階段完成,最後將上下文擴展至32K;SFT階段構建約316萬條樣本,並以SFTLoopEngine用Agent編排訓練、評測、失敗歸因與數據補充的閉環迭代。
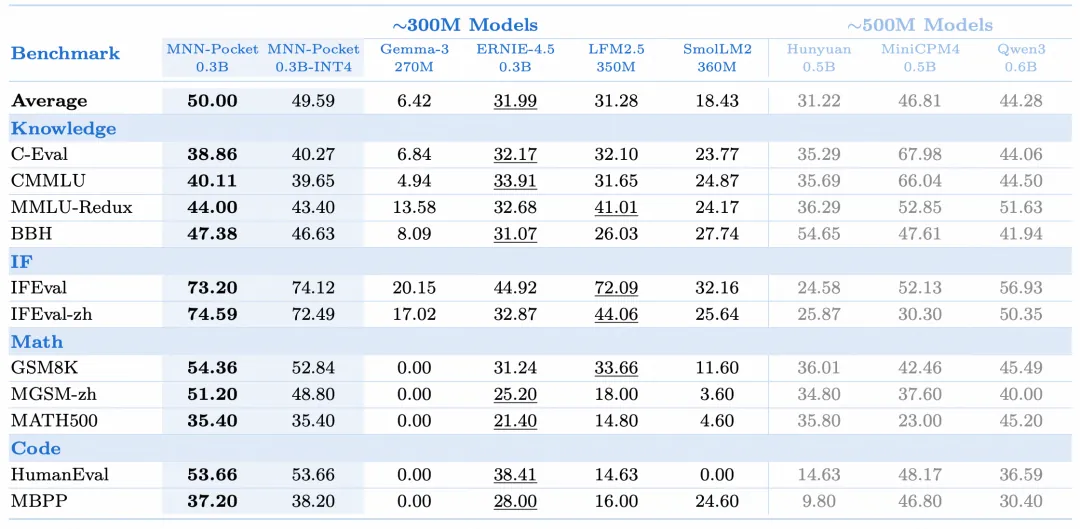
多教師On-Policy蒸餾MOPD按樣本領域選擇四條教師路線,由學生先生成、教師在其上下文上監督,11項評測平均分由35.79提升至50.00;量化感知訓練令INT4版本平均49.59,與BF16僅差0.41分,部署效率與能力得以在同一版本交付。
能力與應用驗證
技術報告評測中,英文IFEval得分73.20、中文IFEval-zh得分74.59,均為所比較模型最高;11項基準平均50.00,高於MiniCPM4-0.5B與Qwen3-0.6B等更大模型,中文數學MGSM-zh 51.20、代碼HumanEval 53.66。
應用驗證選了兩條鏈路。天池電商評論觀點挖掘任務中,以3,229條評論作相同配方微調,F1達80.15,高於同設置下Qwen3-0.6B的77.47與Qwen3-1.7B的78.59,以不到其五分之一的參數取得更高成績。
全端側流式語音系統把識別、生成與合成串成一條本地鏈路,首音頻時延P50由iPad Pro M5的600ms到iPhone 13 Pro的1,055ms;統一設置下九項VoiceBench總分45.44,居所比較語言底座之首。
Base、SFT與指令模型等多階段權重已在GitHub、HuggingFace與ModelScope開放,MNN生態累計16K星標、支持200多款大模型。