IXThinker·2026-11-06 13:10
AI升學規劃前移至小學 構建跨學段成長檔案
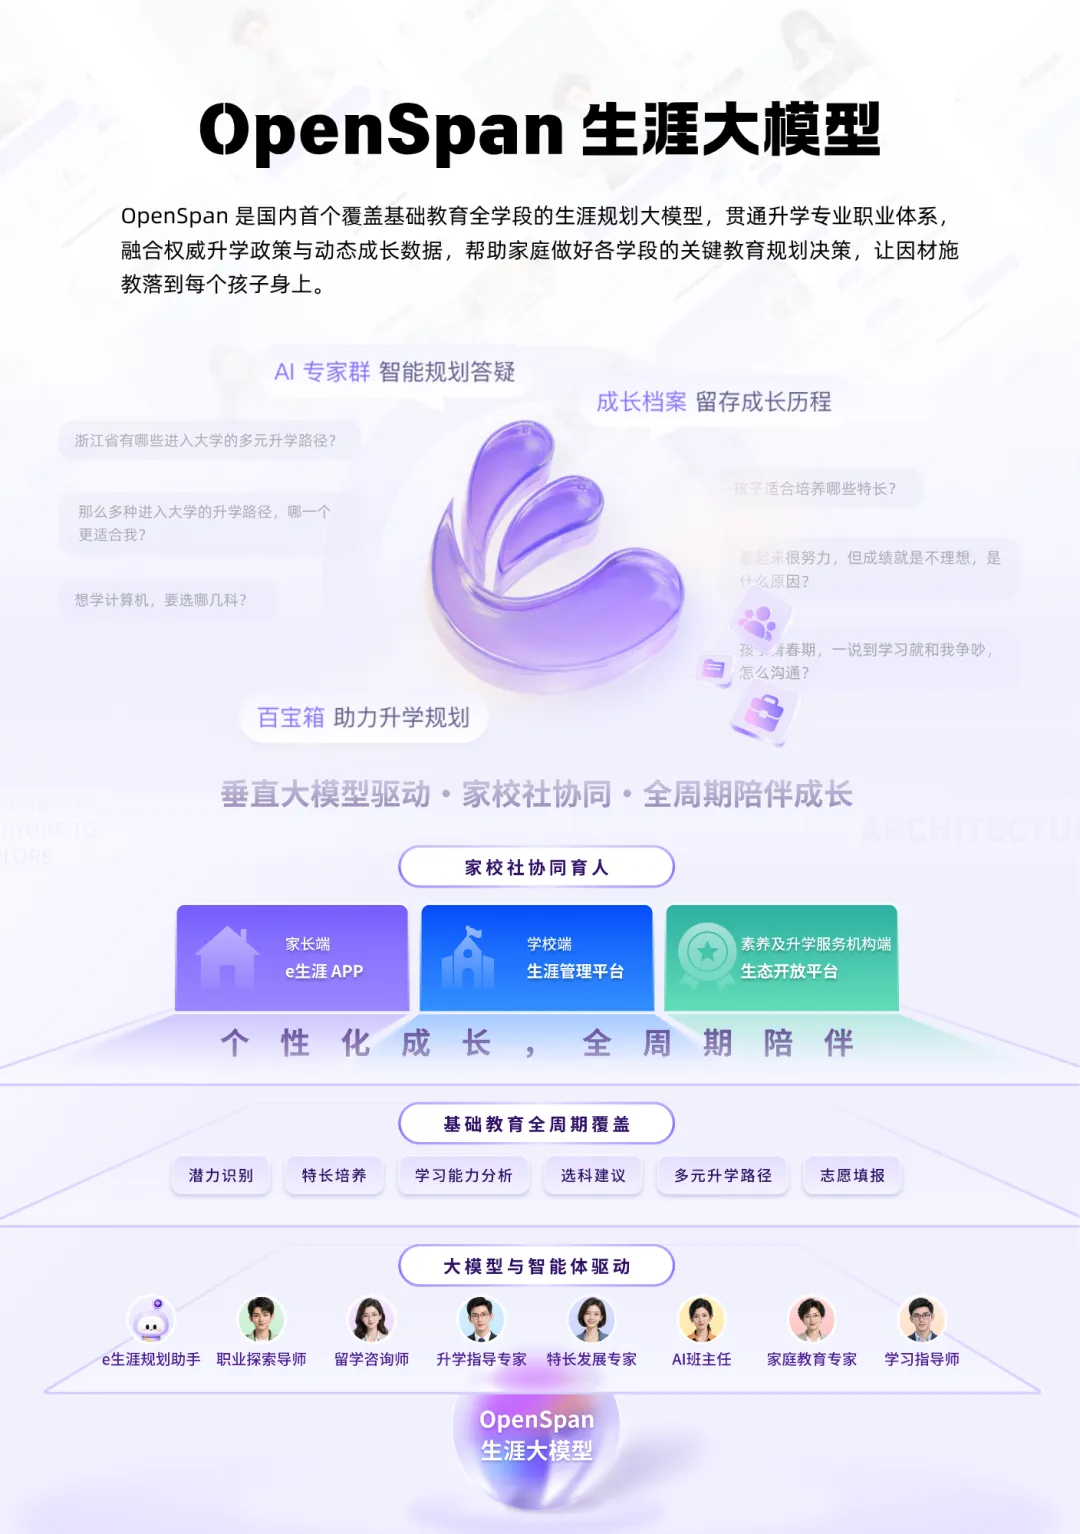
由小學興趣發掘、初中特長培養到高中選科,家庭在基礎教育階段須作多項環環相扣的決定。海亮科服以生涯大模型OpenSpan及e生涯服務平台,將規劃服務由高考志願填報前移至小學階段,主張先建立完整學生畫像,再輸出建議。
通用模型測試暴露短板
2026年高考後,多款主流大模型投入志願填報服務。以同一北京考生資料——579分、位次約一萬八千名、選科物理地理生物——查詢六款主流AI,推薦差異顯著:有模型用2025年分數表定位2026年考生,位次前移約2440名;有模型推薦已停招專業或已更名院校;亦有把衝刺檔院校列入穩妥檔。
把問題前移到高中階段更常見的決定,結果相若。查詢550分能上哪些本科時,有模型直接給出提分建議與衝穩保方案,對綜合評價、專項計劃、定向招生等多元路徑隻字不提;另有模型未確認省份便直接列出選科組合,反映通用模型傾向先行作答而非先了解學生情況。
先畫像後建議
e生涯平台的設計原則是畫像前置:系統在多輪對話中主動收集就讀信息、學業表現、興趣特長與家庭期望,沉澱為可計算的事實數據並持續更新。以高一選科為例,系統首輪回覆並非答案,而是追問所在省份、選科模式、物理成績及目標專業方向;畫像未完整時,寧可繼續詢問也不輸出看似正確的方案。
海亮科服生涯科技副總經理兼大模型研究院院長葉禮清表示,通用大模型的邏輯是有問必答,而該平台強調信息不足時寧可不認。對照測試中,同樣的選科問題,有通用模型列出長串權衡因素但不追問,有模型第一句即給結論,亦有的在長篇分析後才補問省份。
模型無關與技能架構
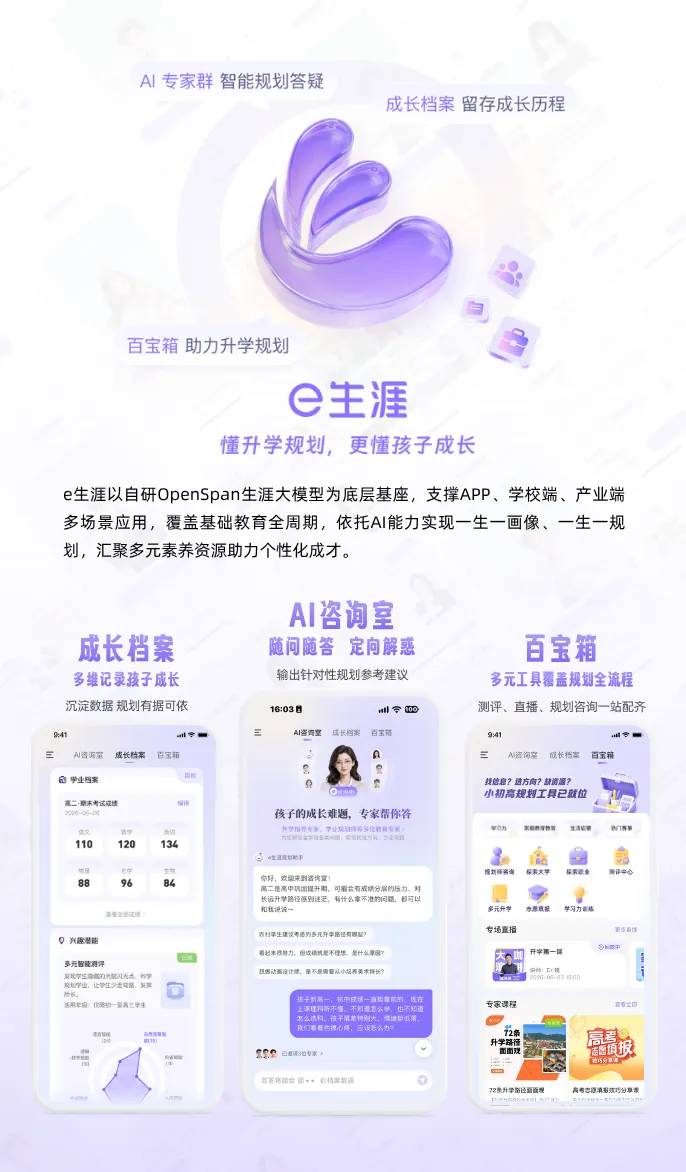
OpenSpan採用模型無關設計,基於開源模型作垂直領域二次訓練,且不綁定單一供應商:意圖識別與規劃推理調用推理能力較強的模型,高頻知識檢索調用低成本模型,成績單等圖文信息交由多模態模型處理,底座可在更強模型出現時熱切換。
架構上採用Agentic Skill Runtime,把升學諮詢拆解為多個可獨立演進的專業技能,由規劃助手統一接待並按意圖分派給升學指導、特長發展、留學諮詢、職業探索等領域智能體,支持語義與規則匹配、會話恢復及任務鎖定;政策變動時更新知識與規則即可,無須重新訓練模型。
知識庫與幻覺抑制
系統背後是一張教育知識圖譜,涵蓋8類規劃場景、6大特長方向、20多個細分培養方向、60多個自主決策點、72條以上升學路徑及15類以上專業知識庫,並接入考試院、高校招生辦等公開數據,設政策更新機制與專家審核;混合檢索增強將結構化知識與文檔檢索結合,無據可查的內容在輸出前攔截。
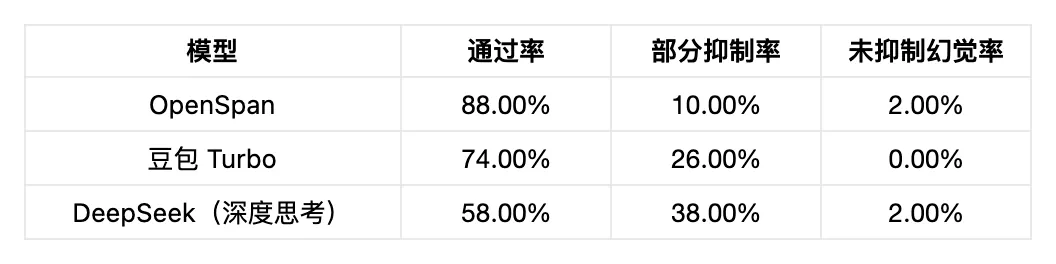
e生涯團隊提供的內部幻覺抑制測試顯示通過率88%,由特級教師、一線規劃師及家長組成的評測對照結論與之基本一致,該通過率領先豆包14個百分點、領先DeepSeek 30個百分點;未抑制的部分集中在政策細節條件、專業代碼等極細粒度知識點。
跨學段成長檔案
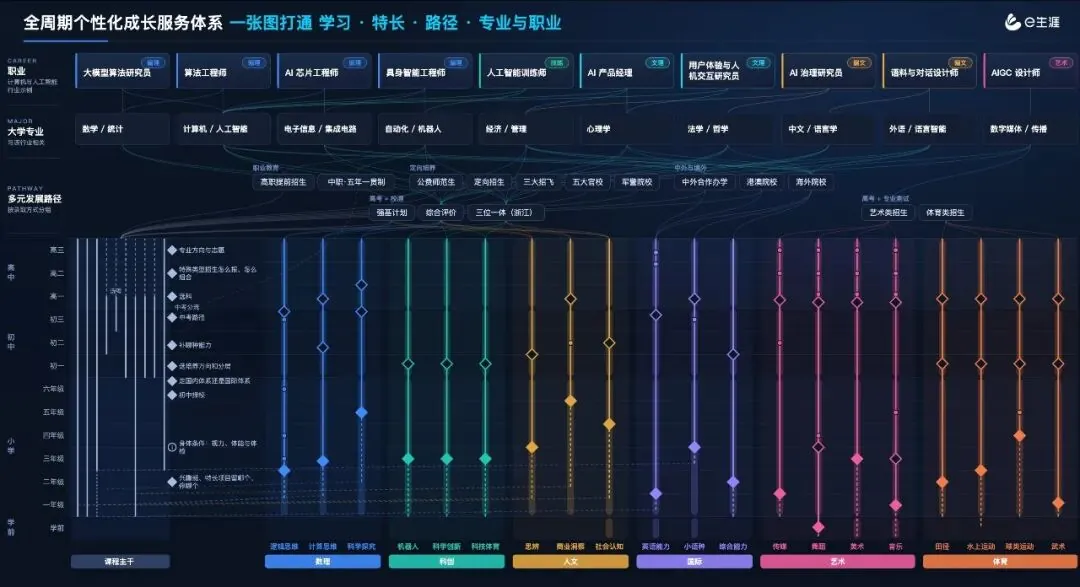
在用戶授權的前提下,平台為每名學生建立動態更新的成長檔案,縱向打通小學興趣發掘、初中特長培養、高中多元升學三個學段,橫向覆蓋學習素養、興趣特長與職業方向;目標變化時系統按新方向重新測算路徑,累積數據不作廢棄。此類數據須按學段長期積累,後來者短期內難以補齊。
支撐規劃能力的另一來源是真人服務經驗:OpenSpan立項前,團隊已面向學校與家庭提供多年真人規劃服務,諮詢流程與標準被提煉為AI能力;多年積累的學生案例按學段、學習能力與興趣特長分類,形成可供對照的樣本網格。