
 IXThinker·2026-11-06 12:50
Astra研究遭覆核質疑 兩類實驗條件有別
本報11月4日曾報道MIT團隊關於Astra的宣稱:無須訓練、不算梯度,僅改Qwen小模型極少權重便令數學成績大升。spaCy作者、Explosion聯合創始人Honnibal近日發文覆核,指論文呈現方式有誤導之處,但亦肯定其工程價值。
原文宣稱:小改權重大提升
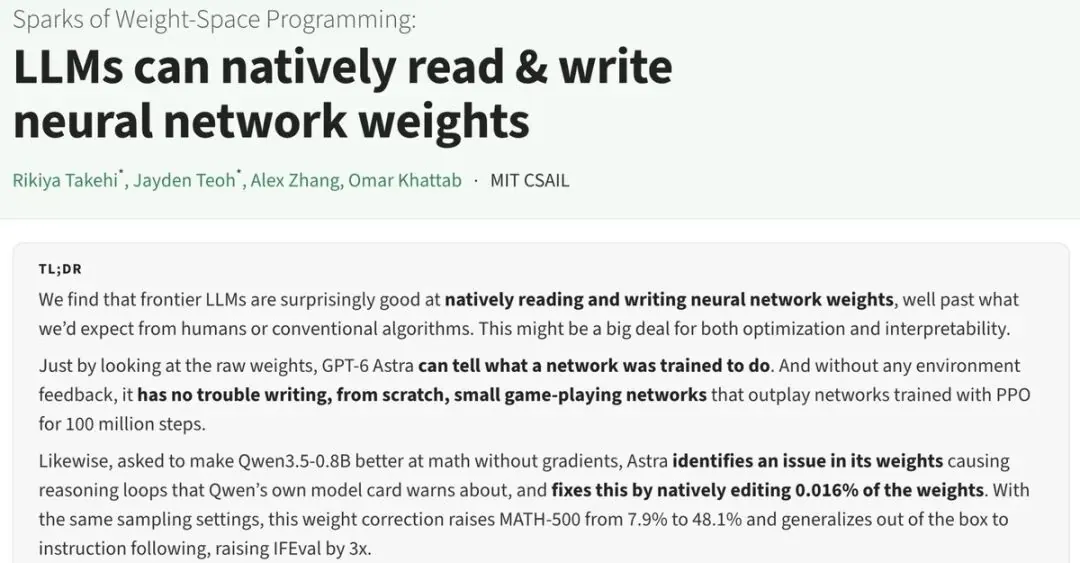
按MIT團隊的說法,Astra無須訓練、不計算梯度,只修改Qwen3.5-0.8B權重的0.016%,其數學測試成績便由7.9%升至48.1%,約為原來的六倍多。該研究發布後在業內廣泛流傳,摘要給人的核心印象是:僅通過觀察原始權重,便能理解並修改另一個模型。
質疑方與覆核方法
提出質疑的Matthew Honnibal是開源NLP庫spaCy的作者,亦是AI公司Explosion的聯合創始人。他以魔術師用不同手法表演同一個戲法作比喻,逐一梳理論文中的8組實驗,比較各組實驗的輸入條件與允許的操作,指出論文宣稱的三項能力實際依賴截然不同的技術路徑。
兩類實驗條件迥異
在識別小型網絡任務、修復卡住的賽車模型等實驗中,Astra確實只接收原始權重數字作輸入,不獲准運行Python代碼,也不能執行目標網絡觀察行為;該模式下處理的參數規模僅約1.7萬至17.2萬個。
而在最受關注的Qwen數學修復實驗中,條件完全不同:Astra並未直接讀取原始權重,而是獲准用Python編程,最多進行50次前向測試,每批處理練習題,觀察表現後再改權重。Honnibal指兩種方式被包裝成同一能力,易令讀者誤以為小模型做法可擴展至8億參數大模型。
Honnibal形容,處理真正的語言模型時,Astra更像一位場外教練,需要通過編程、運行與觀察等工程手段介入,與只看原始權重的讀取方式屬兩回事。
覆核結論與研究價值
覆核結論是:識別小網絡等實驗確實達成只看原始權重,但修復大模型依賴編程與測試反饋,兩者不應混為一談,論文摘要的表述方式才是爭議所在。
與此同時,Honnibal並未否定研究的價值。他承認,讓AI模型在提示下設計並執行原本由人類工程師完成的任務,即編寫代碼分析甚至直接修改網絡權重,本身是明顯進步,一兩年前的模型在這些任務上都會失敗。爭議的核心在於成果如何呈現,而非研究毫無意義。