
 IXThinker·2025-01-08 16:50
陳丹琦團隊新法 數據砍三分之一效能不減
語言模型預訓練語料風格、領域與質量參差,陳丹琦團隊提出以元數據改善異構數據的學習效率,在多個規模下驗證有效,為預訓練降本提供新思路。
核心做法
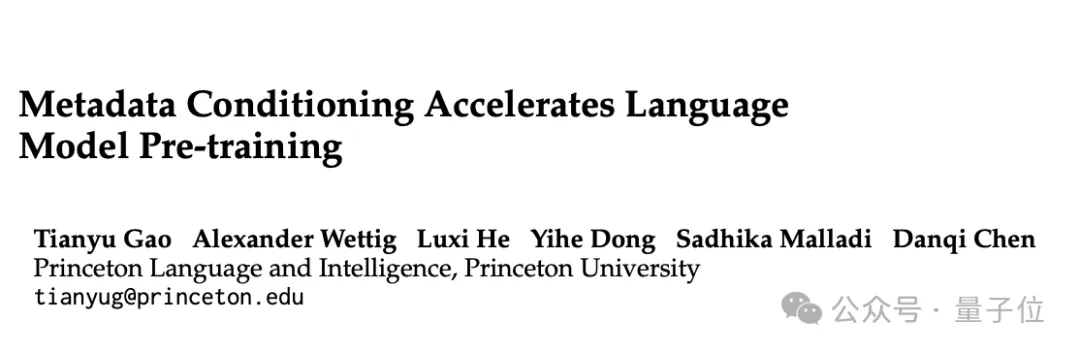
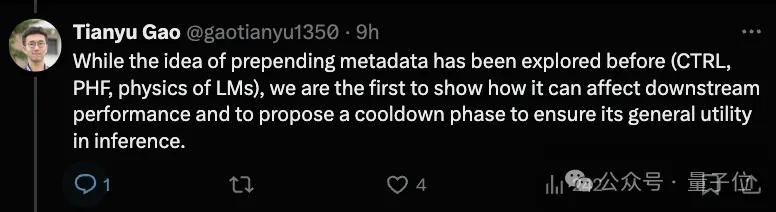
團隊引入元數據以加速大模型預訓練,且不增加單獨的計算開銷;方法針對預訓練語料庫中風格、領域和質量水平的巨大差異,改善異構數據的學習。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。