
 IXThinker·2025-01-15 00:40
哈佛醫學院提SPECTRA 糾正基準數據集泛化評估
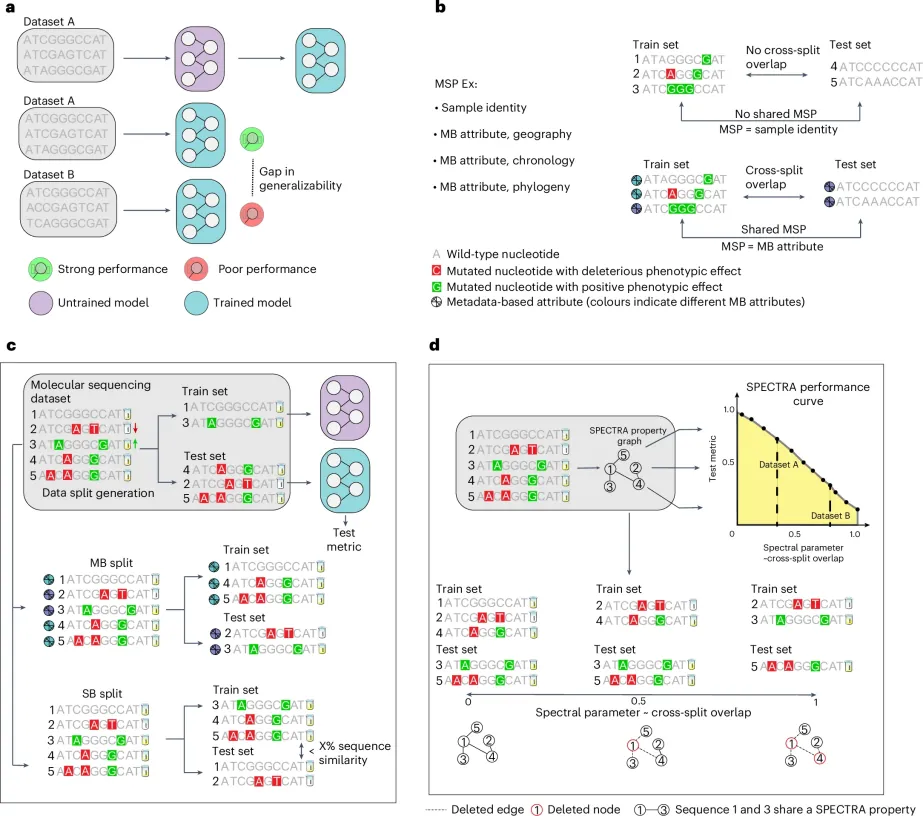
深度學習在分子測序數據建模上進展迅速,但模型是否真正學到通用原理、能否推廣至從未見過的序列,仍然存疑。哈佛醫學院團隊在《自然·機器智能》發表研究,提出評估框架 SPECTRA 直擊這一盲點。
評估盲點所在
傳統基準測試在評估模型性能前,會基於元數據或序列相似度將輸入數據劃分為訓練集和測試集,以此檢驗泛化能力。研究指出,這種做法未充分考慮跨劃分重疊的完整範圍,容易對模型泛化能力產生錯誤刻畫。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。