
 IXThinker·2025-01-16 22:30
PRMBench為過程獎勵模型定標尺
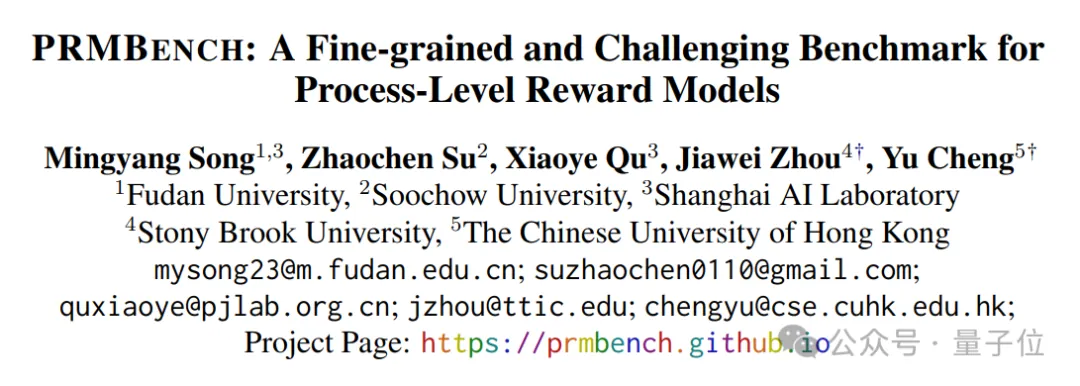
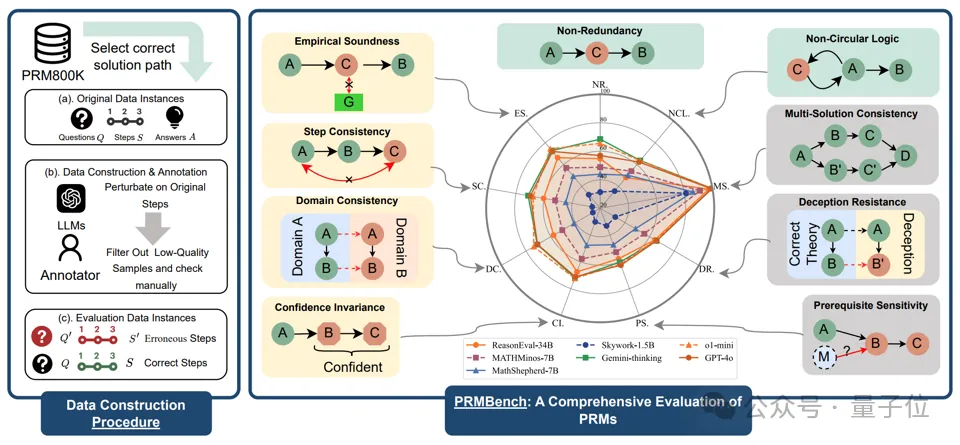
復旦大學、蘇州大學與上海人工智能實驗室等機構聯合提出PRMBench基準,針對過程級獎勵模型缺乏系統評估工具的問題,以6216條題目及逾8萬個步驟級標籤檢驗其糾錯能力。
幕後功臣
o1等強推理模型的出現證明了過程級獎勵模型PRMs的有效性——它負責評估推理過程中每一步是否正確有效,從而引導大語言模型的學習方向,是強推理能力背後的幕後功臣。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。