
 IXThinker·2025-01-17 21:50
495篇文獻梳理大模型多語言短板
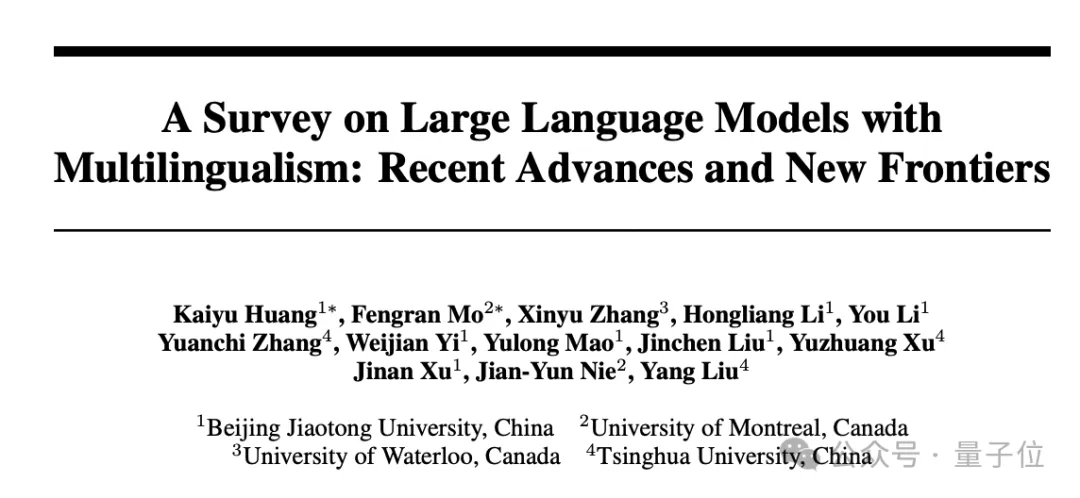
北京交通大學聯同清華大學等院校團隊發表大語言模型多語言能力綜述,引用495篇參考文獻,全面檢視現有模型在多語言場景的進展與短板,並提出未來研究方向。
多語言之困
儘管大模型整體進展亮眼,但在多語言處理上仍有明顯局限。研究指出,數據分布不均、語言結構差異及資源稀缺是主要挑戰,令模型在低資源語言及複雜語境理解上表現欠佳。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。