
 IXThinker·2025-01-24 10:30
祖先序列重建助訓練蛋白質語言模型 降低成本
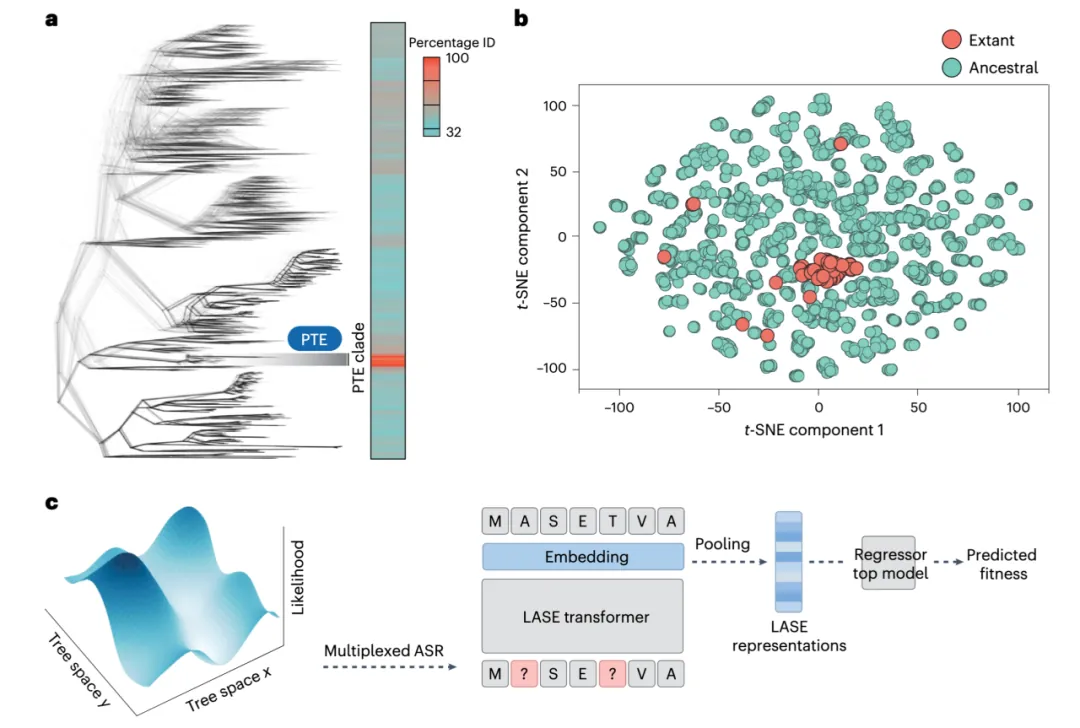
蛋白質語言模型(PLM)規模龐大、訓練成本高,澳洲國立大學團隊改以多重祖先序列重建生成小型功能聚焦數據集,訓練出的模型預測準確度反而更高,論文發表於《自然·機器智能》。
現有瓶頸
PLM將氨基酸序列轉換為數值表徵供機器學習使用,但許多模型規模超過6億參數,需在廣闊的蛋白質序列空間上訓練,在預測準確性與計算成本方面存在局限,限制了更廣泛的科研應用。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。