
 IXThinker·2025-02-20 13:00
SWE-Lancer基準測試AI編程實戰能力
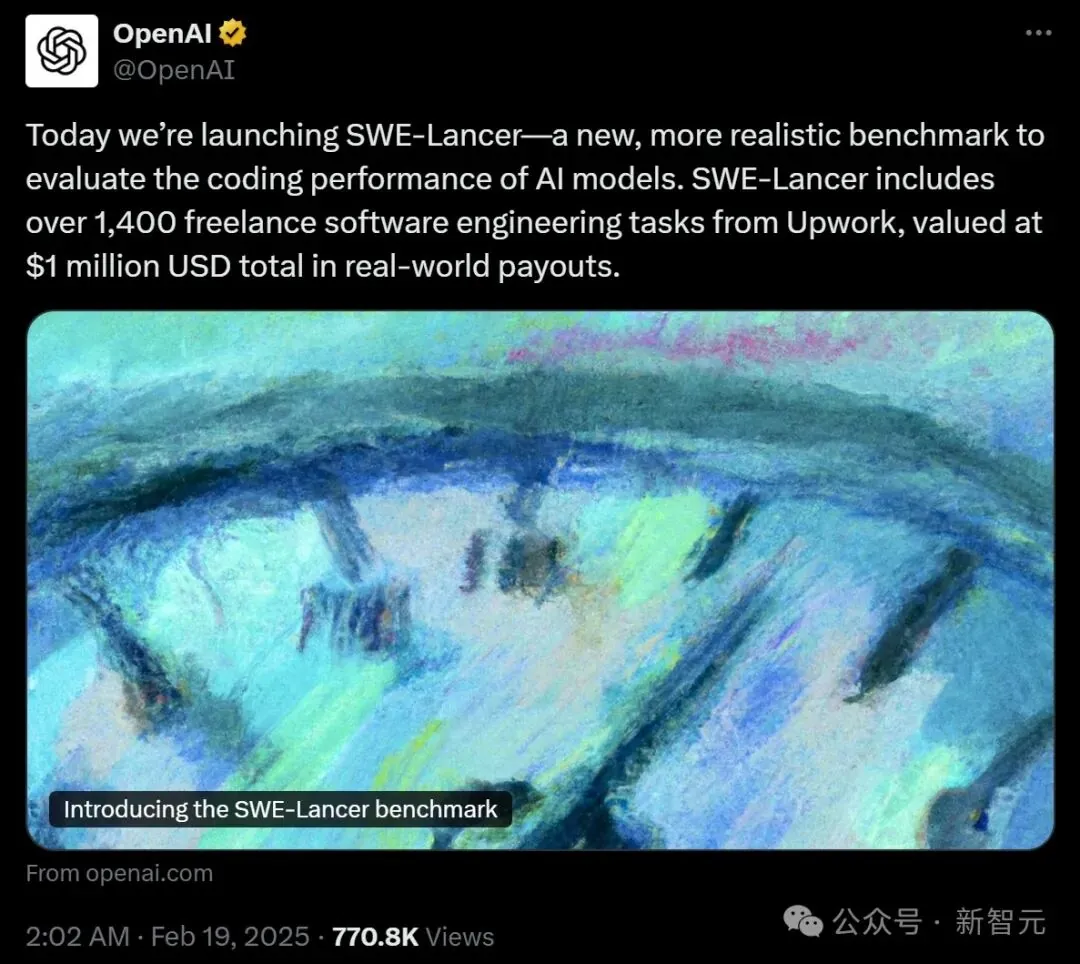
OpenAI發布全新編碼基準SWE-Lancer,讓AI模型挑戰總值100萬美元的真實外包任務,衡量模型在現實工程中的「賺錢」能力;結果Anthropic的Claude 3.5 Sonnet拔得頭籌。
基準設計
SWE-Lancer與以往編碼測試不同,直接採用真實的外包編程任務,任務總價值高達100萬美元,更貼近現實工作場景,用以檢驗AI模型完成實際任務、創造收入的能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。