
 IXThinker·2025-02-25 21:30
MHA2MLA:0.3%數據即可遷移MLA架構
DeepSeek-R1背後的關鍵技術多頭潛在注意力(MLA),如今可以輕鬆移植到其他模型。復旦大學、華東師範大學與上海AI實驗室等聯合提出數據高效微調方法MHA2MLA,只需原始數據0.3%至0.6%即可完成架構轉換。
方法原理
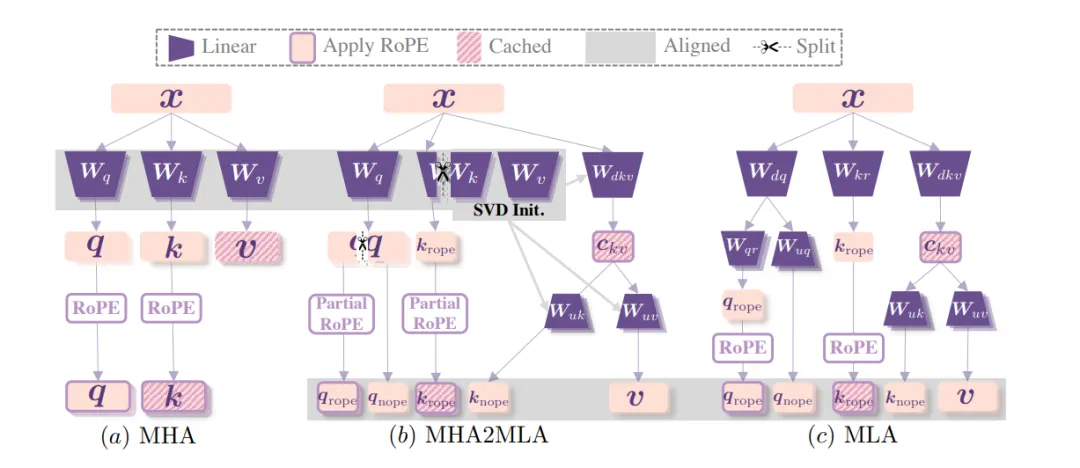
MHA2MLA讓基於多頭注意力(MHA)的大語言模型順利轉換到MLA架構。以Llama2-7B為例,轉換後KV快取大小減少92.19%,而LongBench性能僅下降0.5%,在大幅降低推理成本的同時把性能損失控在很小範圍。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。