
 IXThinker·2025-02-27 12:10
MM-RLHF多模態對齊 10維度全面提升
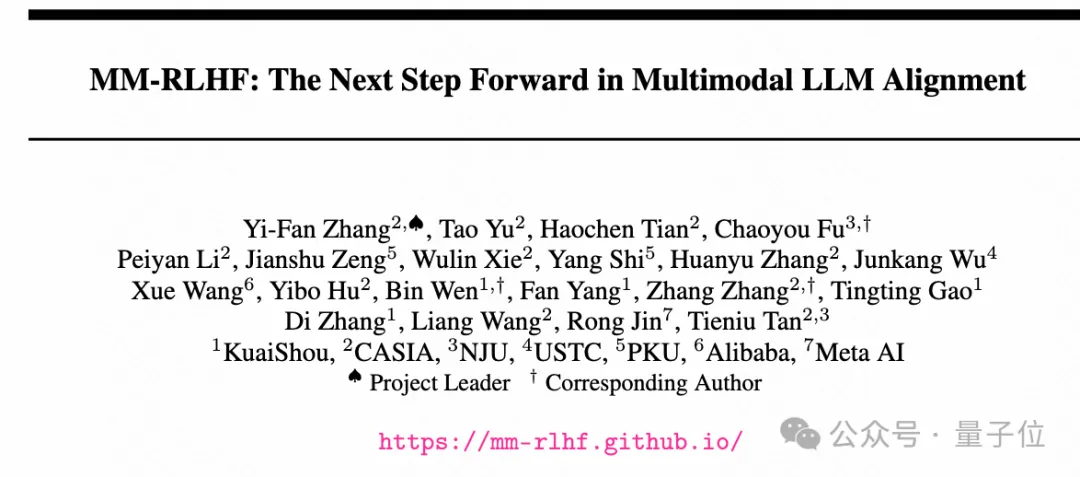
多模態大語言模型(MLLM)能力快速進化,與人類偏好的對齊卻仍有差距。快手、中國科學院與南京大學合作,從數據集、獎勵模型與訓練算法三個層面推進MLLM對齊,交出MM-RLHF方案。
對齊研究缺口
現有對齊研究多集中於減少幻覺等特定領域,與人類偏好對齊能否全面提升MLLM各項能力,此前仍是未知數。團隊針對這一問題展開系統探索。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。