
 IXThinker·2025-02-28 17:50
北大研究 訓練混入兩成亂碼模型照樣能學
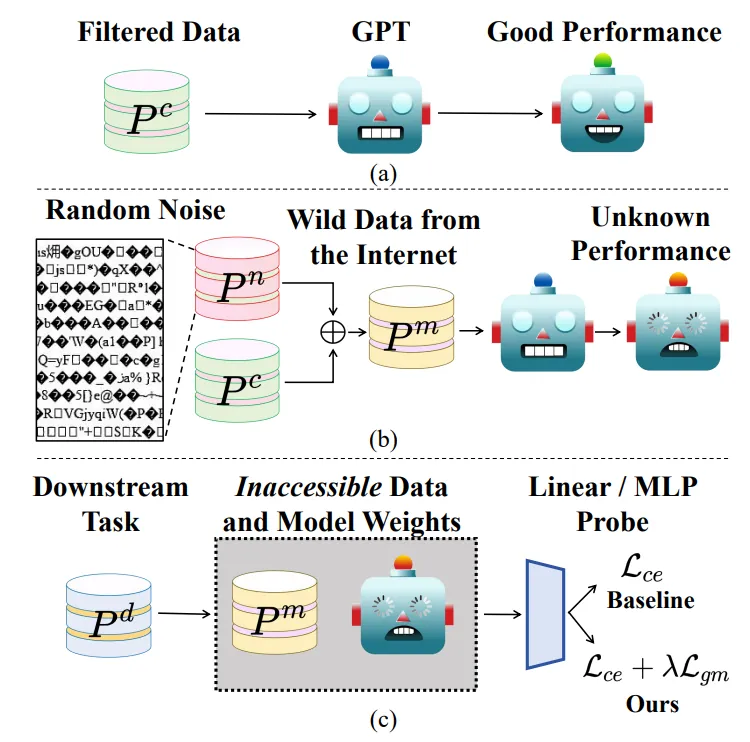
北大團隊挑戰大模型訓練必須依賴純淨數據的傳統觀念,透過刻意混入隨機亂碼的實驗證明:模型對「壞數據」的耐受力遠超想像,嚴格的數據過濾未必不可或缺。
類比孩童習語
傳統訓練依賴經過仔細篩選、符合標準語法且邏輯嚴密的「純淨數據」。研究者的靈感來自孩童學語言:現實中孩子恰恰是在接觸俚語、語法錯誤與背景噪聲的過程中,依然能夠掌握語言能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。