
 IXThinker·2025-03-04 12:00
研究指小分子數據集存在顯著覆蓋偏差
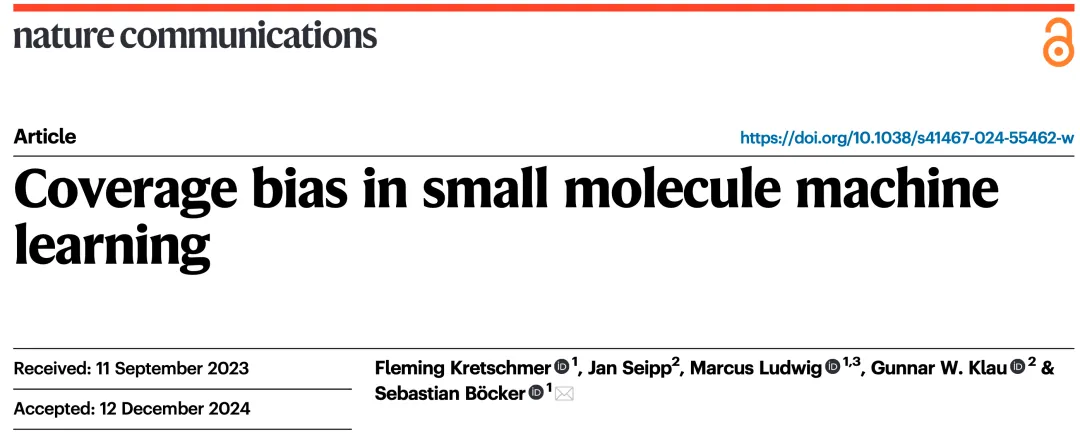
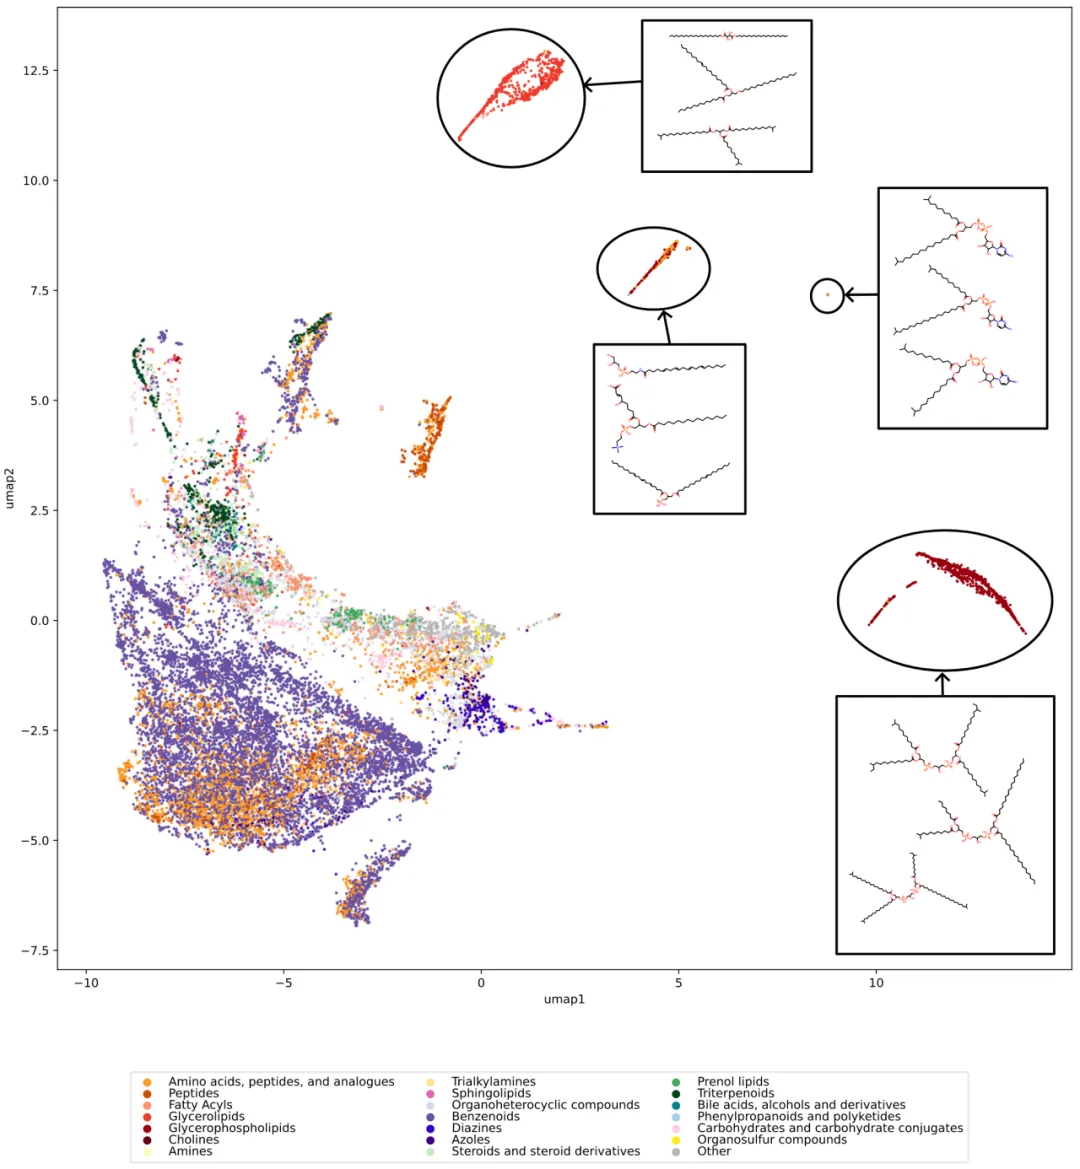
小分子機器學習旨在從分子結構預測化學或生物特性,應用遍及毒性預測、配體結合與藥代動力學。耶拿大學團隊的最新研究揭示數據集覆蓋偏差的隱憂。
研究焦點
近年趨勢是開發無需顯式領域知識的端到端模型,此類模型假設訓練與評估數據沒有覆蓋偏差、能代表真實分佈,但實際上甚少考慮模型的適用性範圍。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。