
 IXThinker·2025-03-04 11:40
LLM自我糾錯新框架 數學推理能力大增
LLM在推理任務中表現亮眼,自我糾正能力卻一直是短板。UIUC與馬里蘭大學的全華人團隊提出新框架,讓模型像老師一樣檢查並改正自己的答案。
框架設計
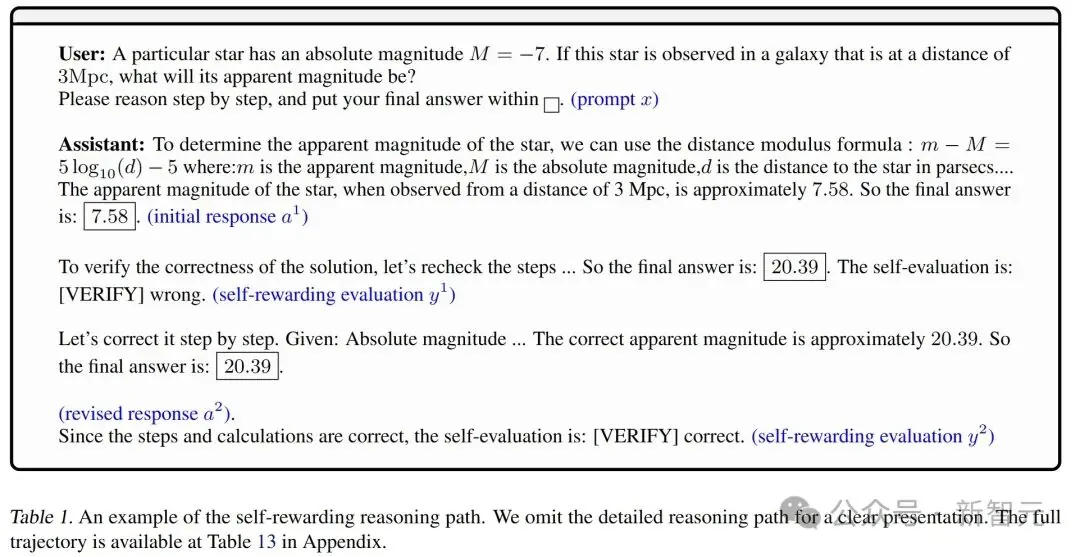
該框架名為Self-rewarding correction for mathematical reasoning,將生成、評估與糾正三種能力集成於單一LLM之中,無需外部幫助即可提升答案的準確性。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。