
 IXThinker·2025-03-04 09:50
從零實現GRPO:DeepSeek關鍵算法動手教程
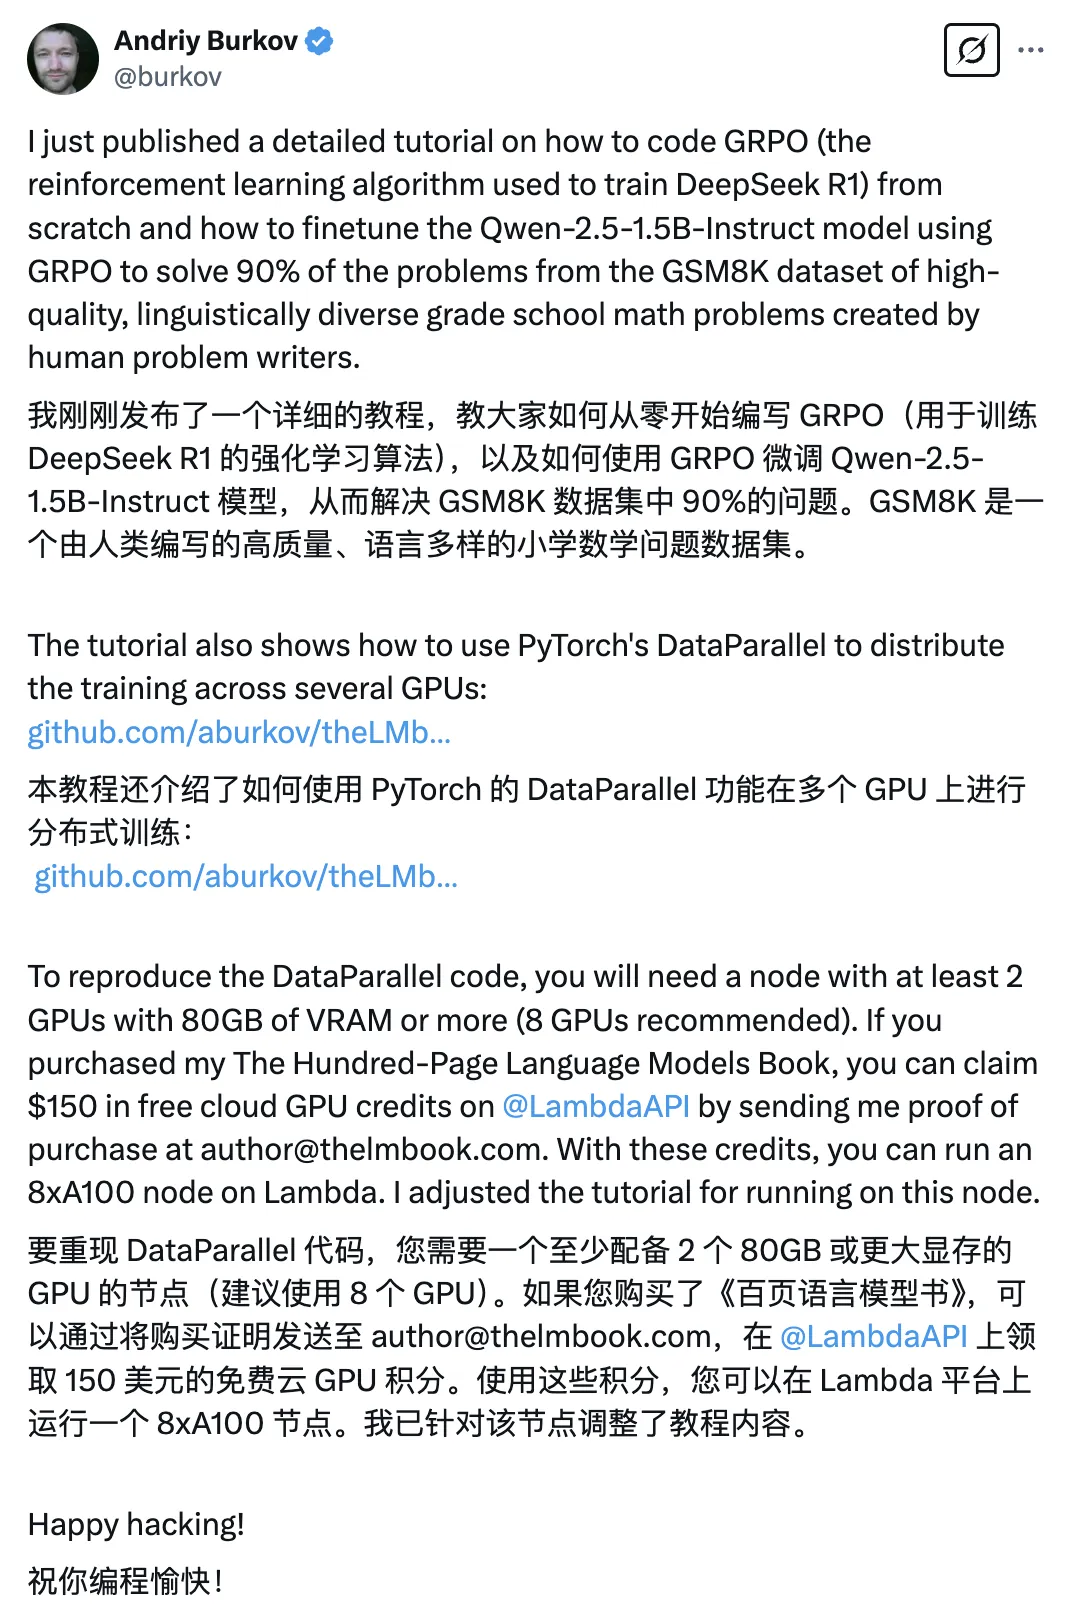
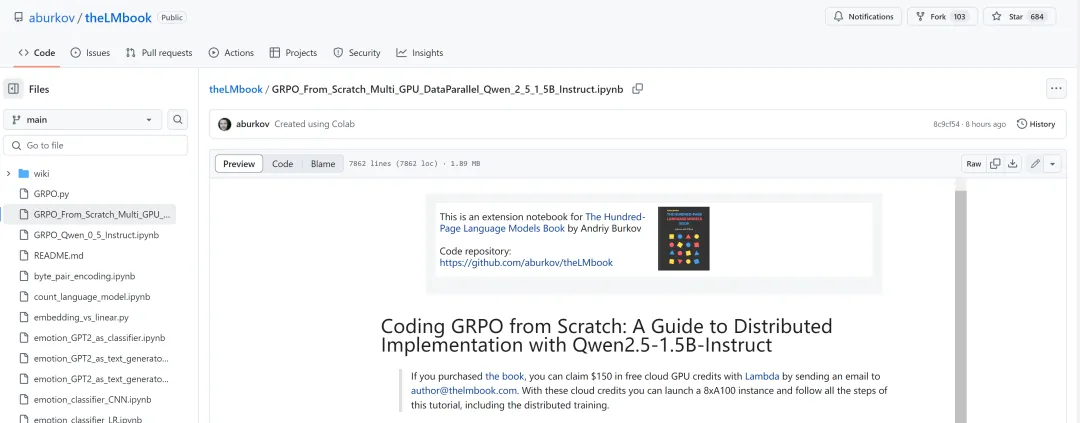
DeepSeek-R1的成功離不開強化學習算法GRPO。這種算法究竟如何運作?有AI工程師發布從頭開始編寫GRPO代碼的教程,拆解其實現細節。
算法原理
GRPO(Group Relative Policy Optimization)捨棄了critic model,放棄價值函數近似,改為透過組內樣本的相對比較來計算策略梯度,思路與傳統方法明顯不同。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。