
 IXThinker·2025-03-05 22:00
MoE新變體CoE問世 記憶體需求最多減42%
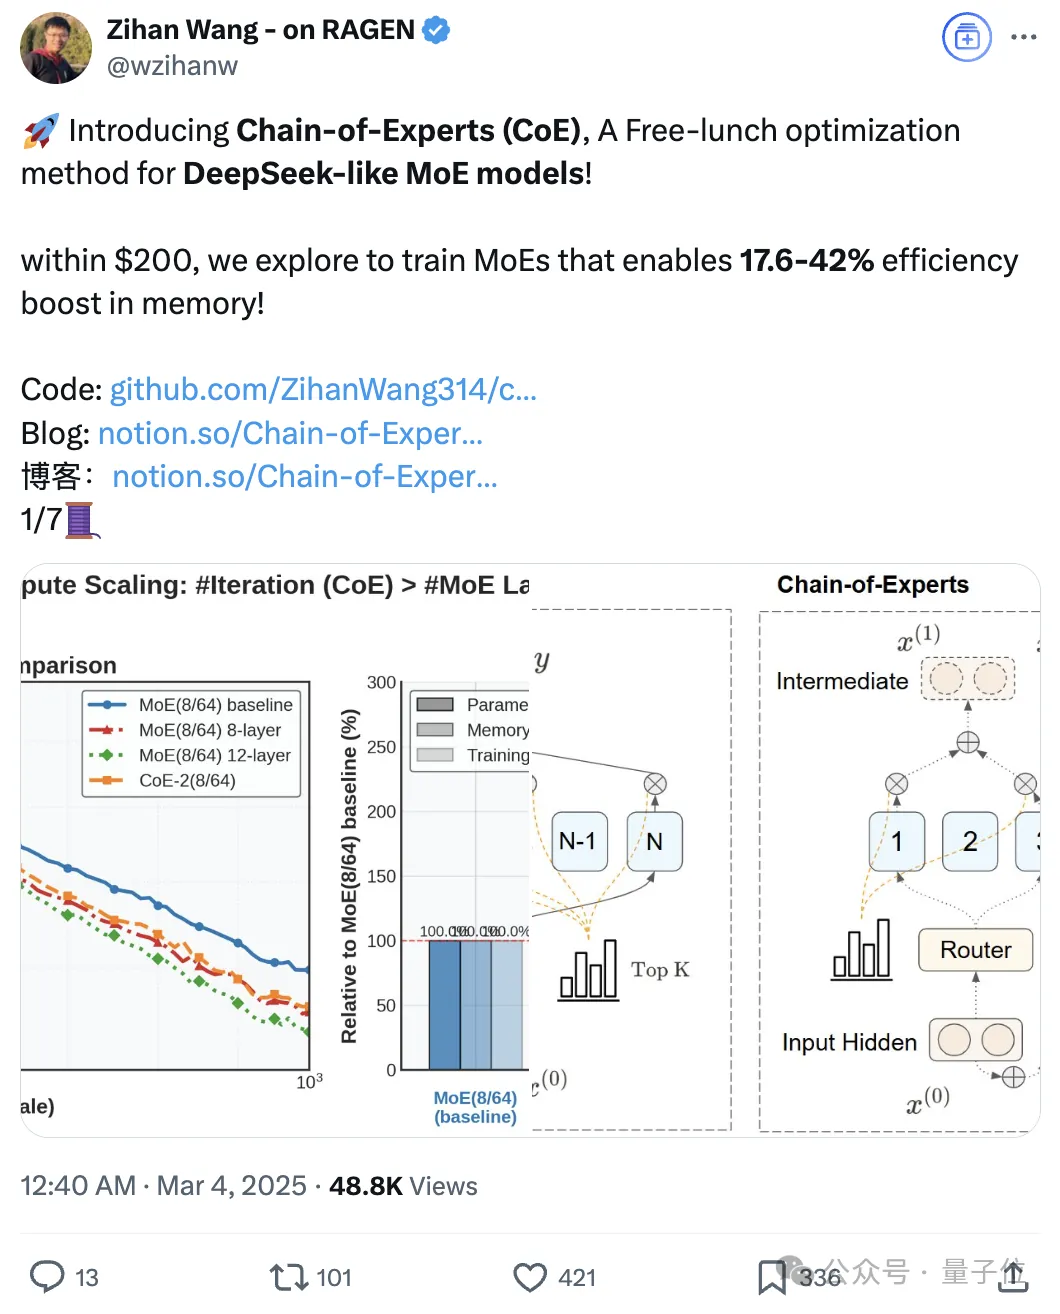
被稱為MoE「變體」的CoE(Chain-of-Experts)方法近期受到關注:透過讓專家在單層內串行溝通、迭代處理token,在相同計算預算下提升性能並大幅減少記憶體需求,被形容為「免費午餐」式優化。
突破MoE局限
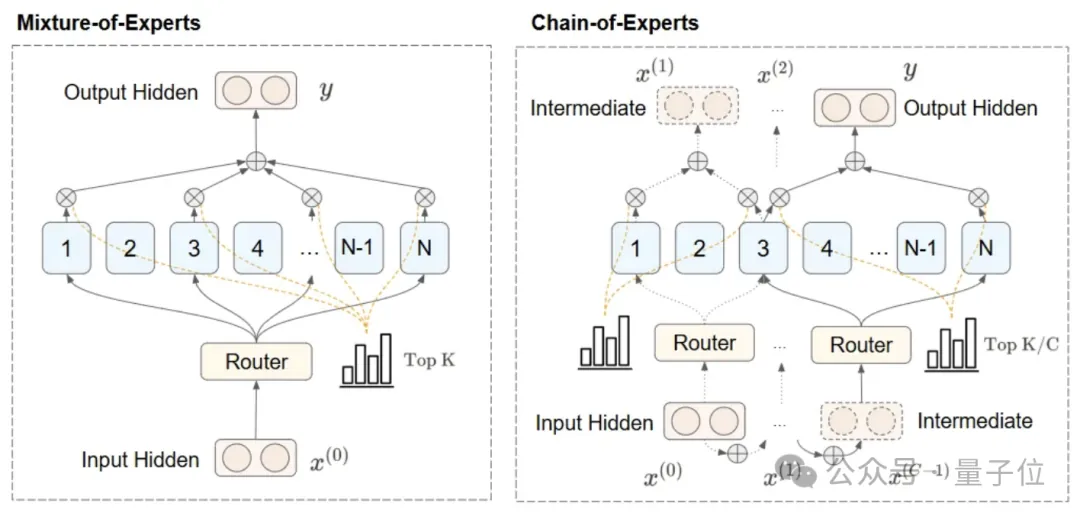
傳統MoE模型並行獨立處理token,整體參數數量龐大,需要大量記憶體資源。CoE改為讓專家在單層內串行通信,形成迭代機制:專家可以在其他專家的輸出之上處理token,重新組織了資訊流。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。