
 IXThinker·2025-03-13 15:50
騰訊UPFT方法 微調前8至32詞即可奏效
大模型推理訓練的成本能否再壓縮?騰訊AI Lab聯同香港中文大學(深圳)的研究給出肯定答案:只需微調模型生成的前幾個詞,推理能力已可看齊傳統監督訓練。
推理前序自一致性
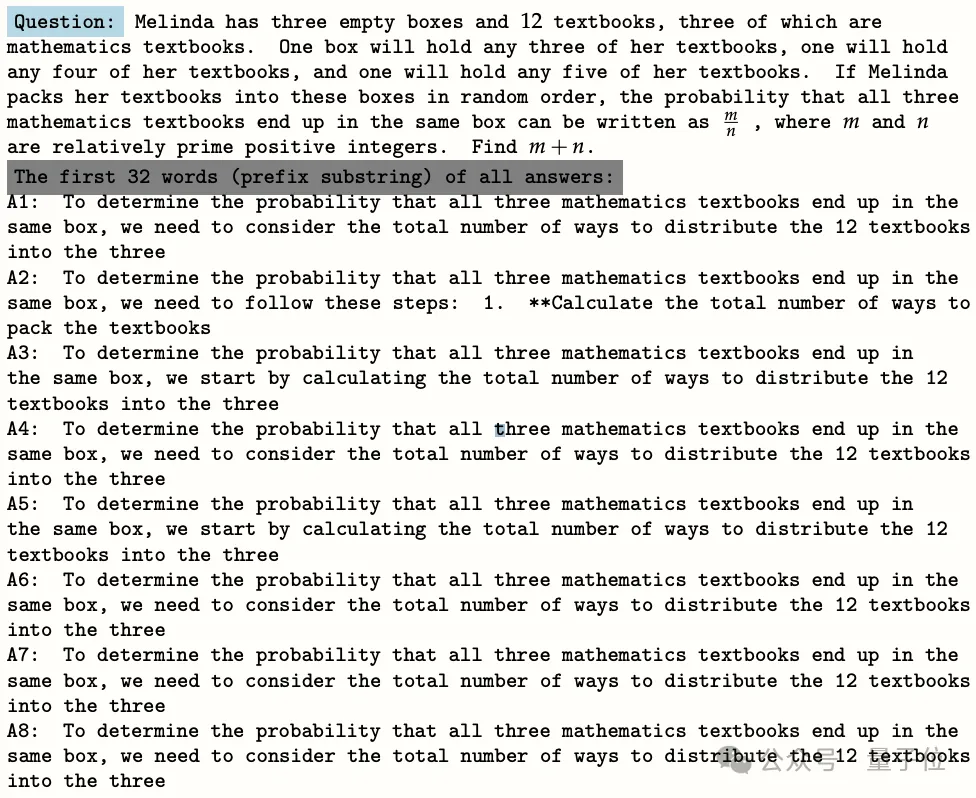
團隊研究發現,關鍵的正確推理訊號全都藏在模型生成內容的「前幾步」裏,並將此現象命名為推理前序自一致性,為大幅精簡訓練流程提供了理論依據。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。