
 IXThinker·2025-03-18 15:50
SlimAttention:KV快取減半不損精度
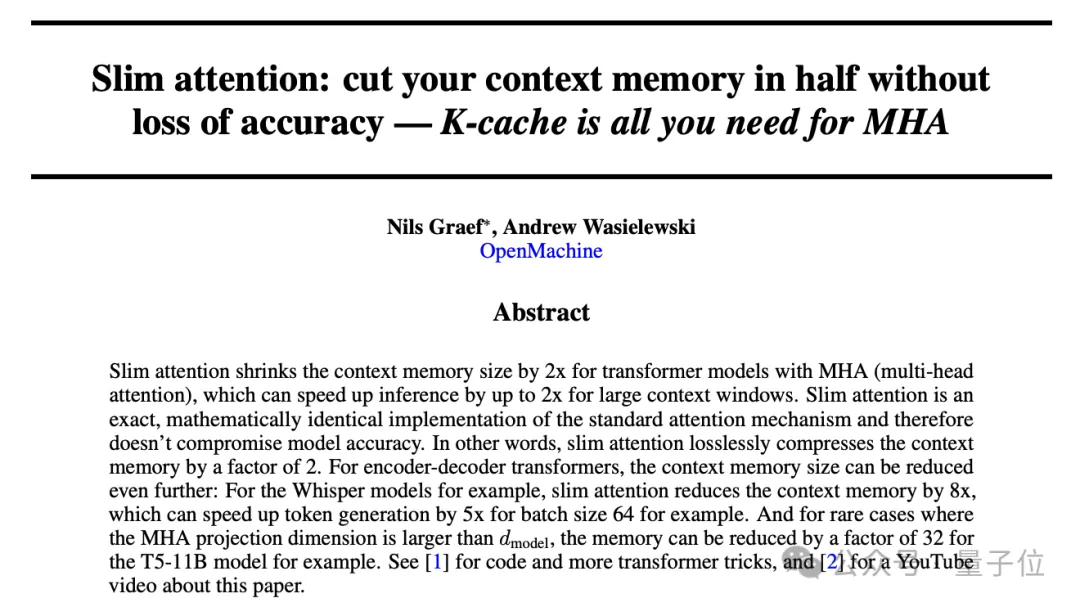
前蘋果ASIC架構師Nils Graef與一名UC伯克利在讀本科生提出新注意力機制Slim Attention,讓大模型在相同上下文窗口下只需一半內存,且精度完全無損。
機制原理
Slim Attention以標準多頭注意力(MHA)為基準,對其中value快取的處理過程進行調整,實現更少的內存佔用。有網民評價,這個方法雖然簡單,卻十分巧妙。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。