
 IXThinker·2025-03-28 23:30
Vamba混合架構降低長影片理解記憶體消耗
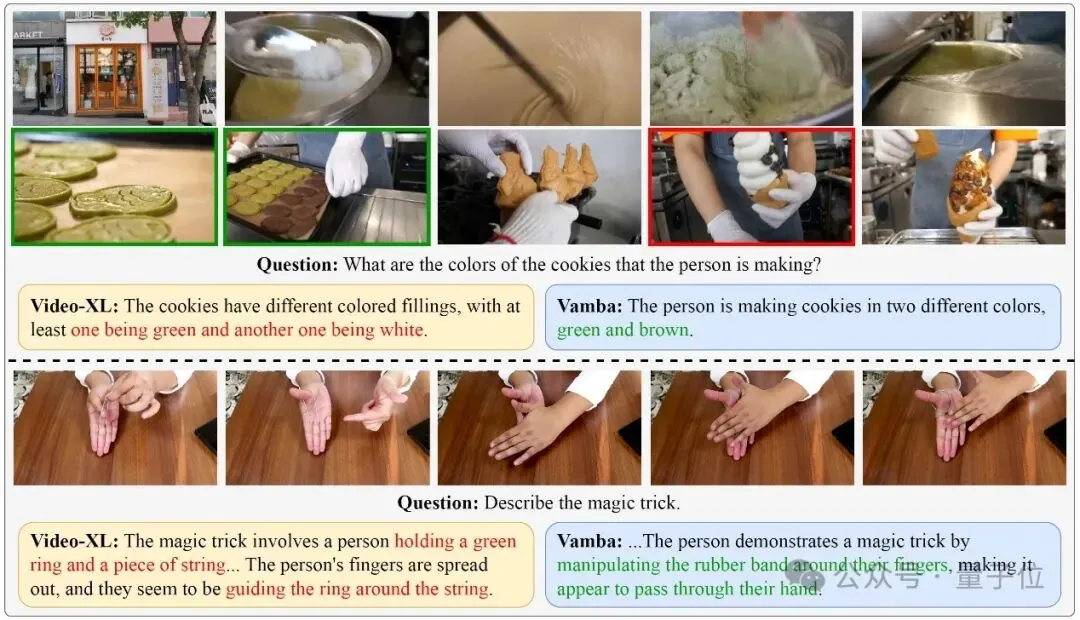
滑鐵盧大學陳文虎團隊聯合多倫多大學、零一萬物等機構提出Mamba-Transformer混合影片模型Vamba,不壓縮影片token,而是改進架構設計,大幅提升長影片理解的訓練與推理效率。
技術路線
與傳統對影片token進行壓縮的做法不同,Vamba選擇從模型架構本身入手,透過Mamba與Transformer的混合設計,提升訓練及推理預填充階段處理影片token的效率,思路自成一格。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。