
 IXThinker·2025-04-19 22:10
哈工大GiVE破解AI視覺選擇性失明
多模態大模型看似能理解圖像,實則像戴着眼罩的觀察者,只關注最顯眼主體。哈工大(深圳)博士生李俊劼的成果GiVE實現指令驅動的全景式感知,破解這一「選擇性失明」。
缺陷剖析
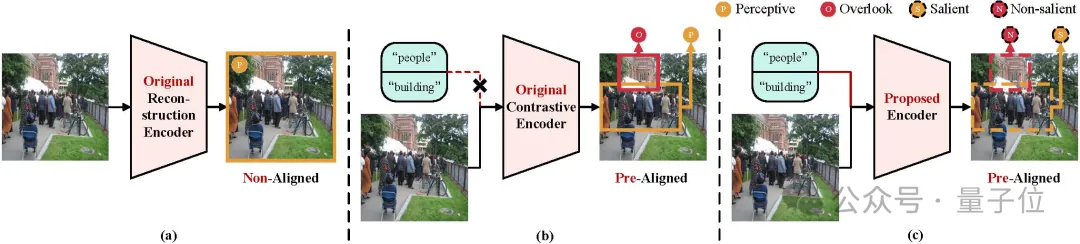
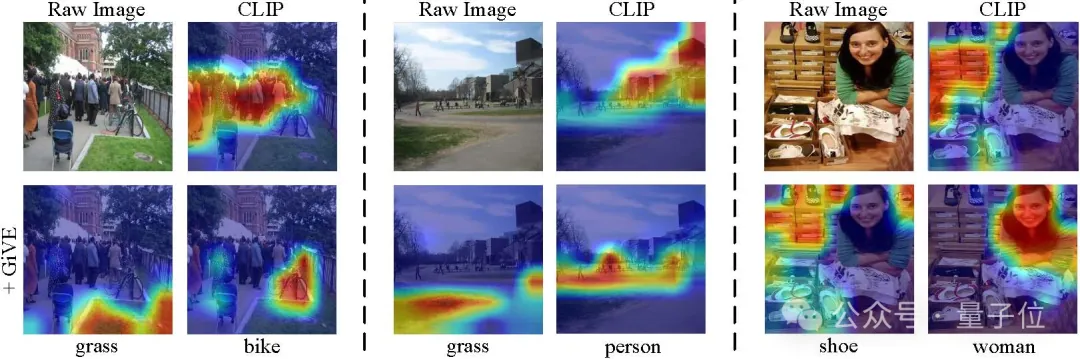
當今BLIP-2、LLaVA等模型被問及「圖中左側的單車」或「背景廣告牌上的文字」時,常因視覺編碼器的視野局限而答非所問,或誤判對象位置,或完全忽略非顯著資訊。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。