
 IXThinker·2025-04-23 10:33
研究:強化學習未擴展LLM推理只優化採樣
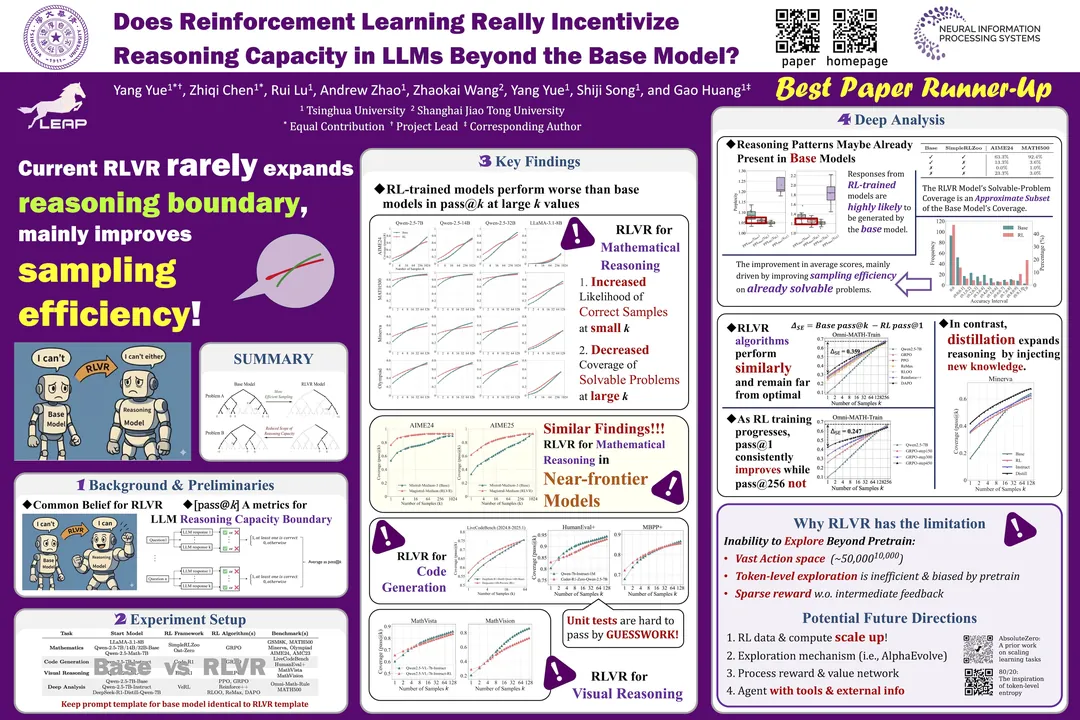
一項研究檢視RLVR(可驗證獎勵強化學習)是否真正擴展了大語言模型的推理能力,結論是:它主要優化採樣效率,而非創造新能力,所有正確解早已存在於基礎模型的分佈之中。
pass@k曲線
跨多個數學基準、多個LLM系列的實驗顯示:k較小時(如pass@1),RL訓練模型勝過基礎版本;但隨k增至數十甚至數百,基礎模型在所有基準上一致追平並最終反超RL訓練模型,無一例外。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。