
 IXThinker·2025-04-25 22:00
強化學習結合大模型的四層階梯 通往AGI之路解析
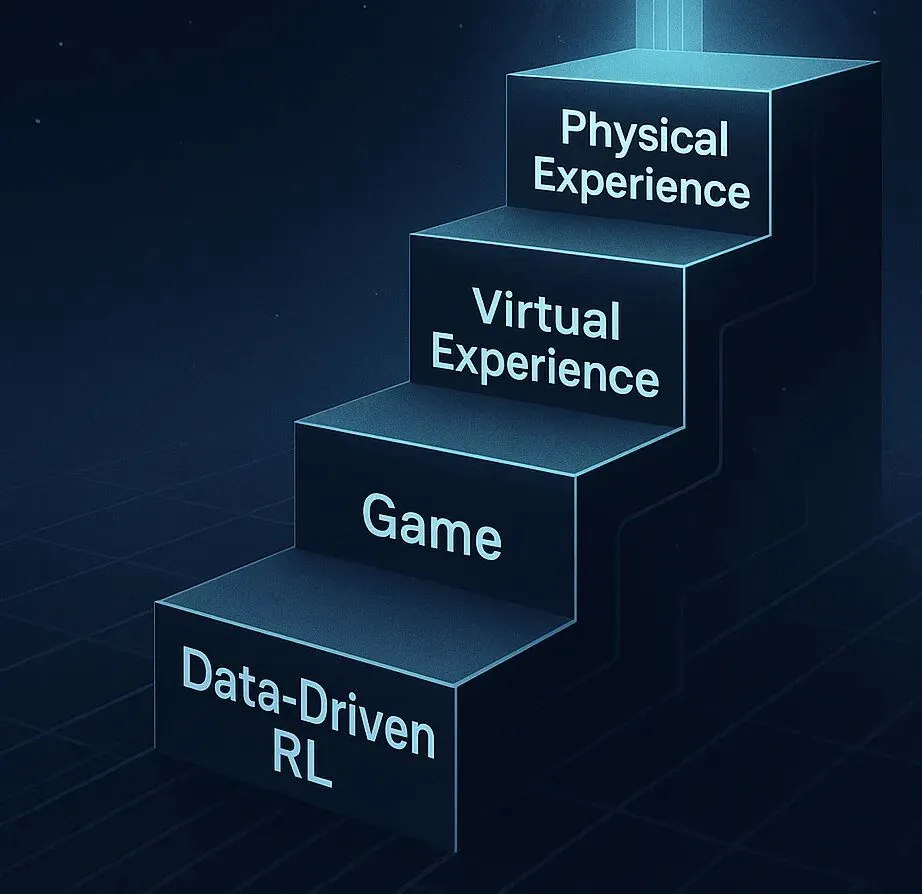
有研究者發文探討強化學習與大語言模型結合的升級路徑,提出RL加LLM融合的四層階梯,並回顧Sutton與Barto獲圖靈獎等標誌事件,認為RL正於後訓練時代強勢回歸。
強化學習破局回歸
作者孫浩在文章開篇回顧,二零二五年伊始,強化學習以破局歸來的姿態,在大語言模型的後訓練時代重新證明了自身的巨大價值。此舉為業界帶來新的思考。
Sutton與Barto兩位學者憑藉對強化學習領域的奠基性貢獻榮獲圖靈獎,成為這一波研究熱潮回歸的標誌性事件,為業界注入信心。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。