
 IXThinker·2025-04-26 12:20
MIT夥劍橋用大模型挖文獻 建千條肽自組裝數據庫
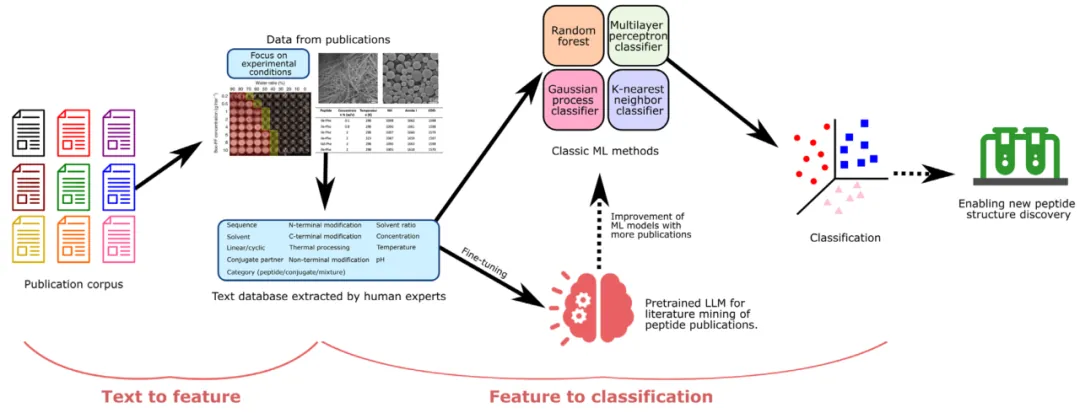
麻省理工與劍橋大學團隊在科學進展發表新研究,結合專家手動整理與大模型輔助文獻挖掘,建成逾千條數據的肽自組裝數據庫,並訓練出分類準確率超過八成的機器學習模型。
肽自組裝缺全局圖景
肽是無處不在且十分重要的生物分子,能夠自組裝成多樣化的結構,其化學組成與外部條件對自組裝的影響已有大量研究積累。這對相關領域是一大利好。
然而,學界一直缺乏一項系統性的整合工作,把這些分散的實驗數據匯聚起來,用以揭示肽自組裝背後的全局規律與共性機制。相關話題近期備受討論。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。