
 IXThinker·2025-04-27 17:40
清華交大研究:強化學習未必賦予模型新推理力
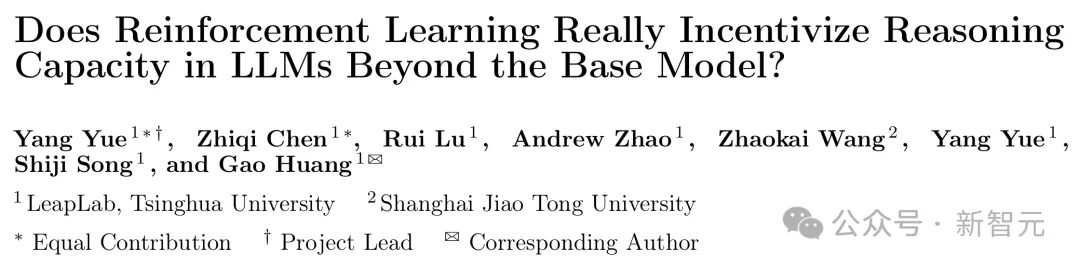
可驗證獎勵強化學習(RLVR)被視為打造自我進化大模型的關鍵技術,支撐起OpenAI o系列與DeepSeek-R1等推理模型的突破。然而清華大學與上海交通大學的最新研究提出挑戰:RLVR可能只是提升採樣效率,並未真正教會模型新知識。
技術背景
以推理能力為核心的大語言模型已成主流,OpenAI o系列、DeepSeek-R1等在數學、編程等複雜邏輯問題上表現突出。相比依賴人工標注的指令微調,關鍵突破來自可驗證獎勵強化學習(RLVR),讓模型循可驗證的獎勵信號自我改進。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。