
 IXThinker·2025-04-28 11:10
無損壓縮技術令LLM體積減三成提速近39倍
大模型規模爆炸式增長,量化壓縮雖能降低顯存需求,卻以犧牲精度為代價。美國萊斯大學團隊提出的DFloat11打破這一僵局:模型體積縮減30%而輸出與原始模型逐位一致,配合定制GPU解壓縮核心,推理吞吐量最高提升38.8倍。
有損之弊
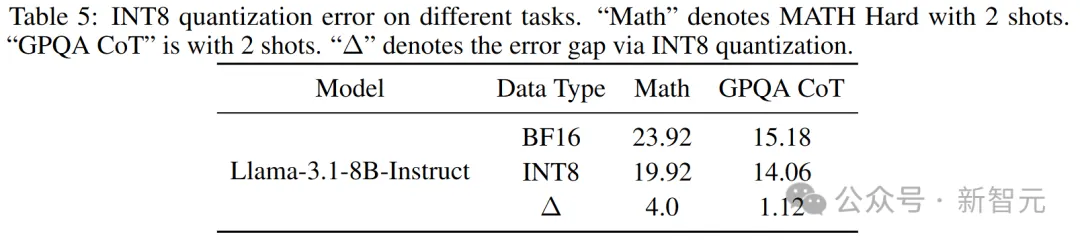
量化是目前主流的模型壓縮手段,可大幅降低對顯存的需求,但本質屬有損壓縮,模型的輸出分佈難免受影響,直接削弱準確性與可靠性。人人都想擁有自己的大模型,卻未必負擔得起需要一打96GB顯存高端晶片的方案,壓縮與精度遂成兩難。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。