
 IXThinker·2025-05-05 09:30
四校研究揭災難性過度訓練現象
CMU、史丹福、哈佛與普林斯頓團隊提出「災難性過度訓練」:預訓練Token越多,模型在後訓練階段反而可能變差,挑戰「數據越多越好」的傳統觀念。
顛覆傳統認知
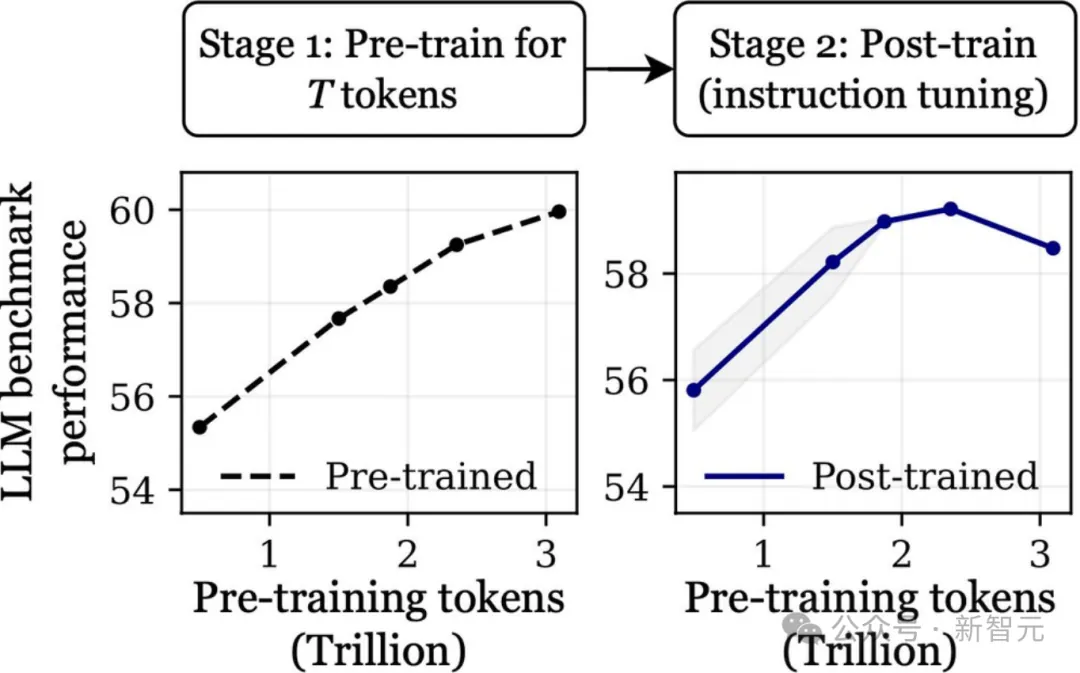
增加更多預訓練數據,語言模型就會更好?四大名校團隊以實驗給出否定答案:過量預訓練可能導致後訓練階段性能下降,這一現象被命名為「災難性過度訓練」(Catastrophic Overtraining)。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。