
 IXThinker·2025-05-09 19:20
R1-Reward以強化學習穩定訓練多模態獎勵模型
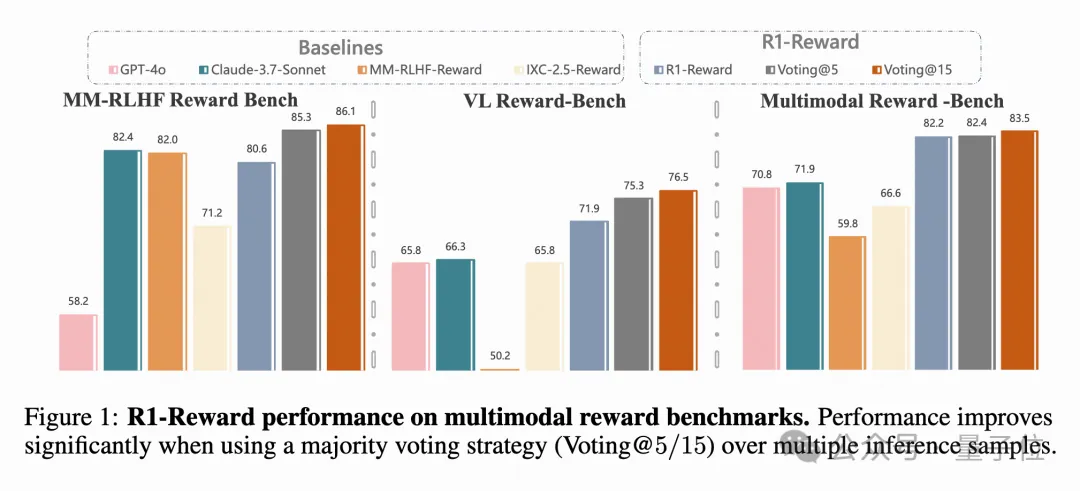
中科院自動化所、清華大學、快手與南京大學團隊提出R1-Reward,利用強化學習穩定而有效地訓練多模態獎勵模型(MRM),破解直接套用現有RL算法時訓練不穩甚至崩潰的難題,為多模態大模型引入長期推理能力。
獎勵模型的角色
多模態獎勵模型(MRM)對提升多模態大語言模型(MLLM)表現至關重要:訓練階段可提供穩定的reward,評估階段可挑選更佳的樣本結果,單獨使用時亦可直接作為評估器,用途相當多元。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。