
 IXThinker·2025-05-11 10:40
華人學者新研究:RL微調本質上是統計過程
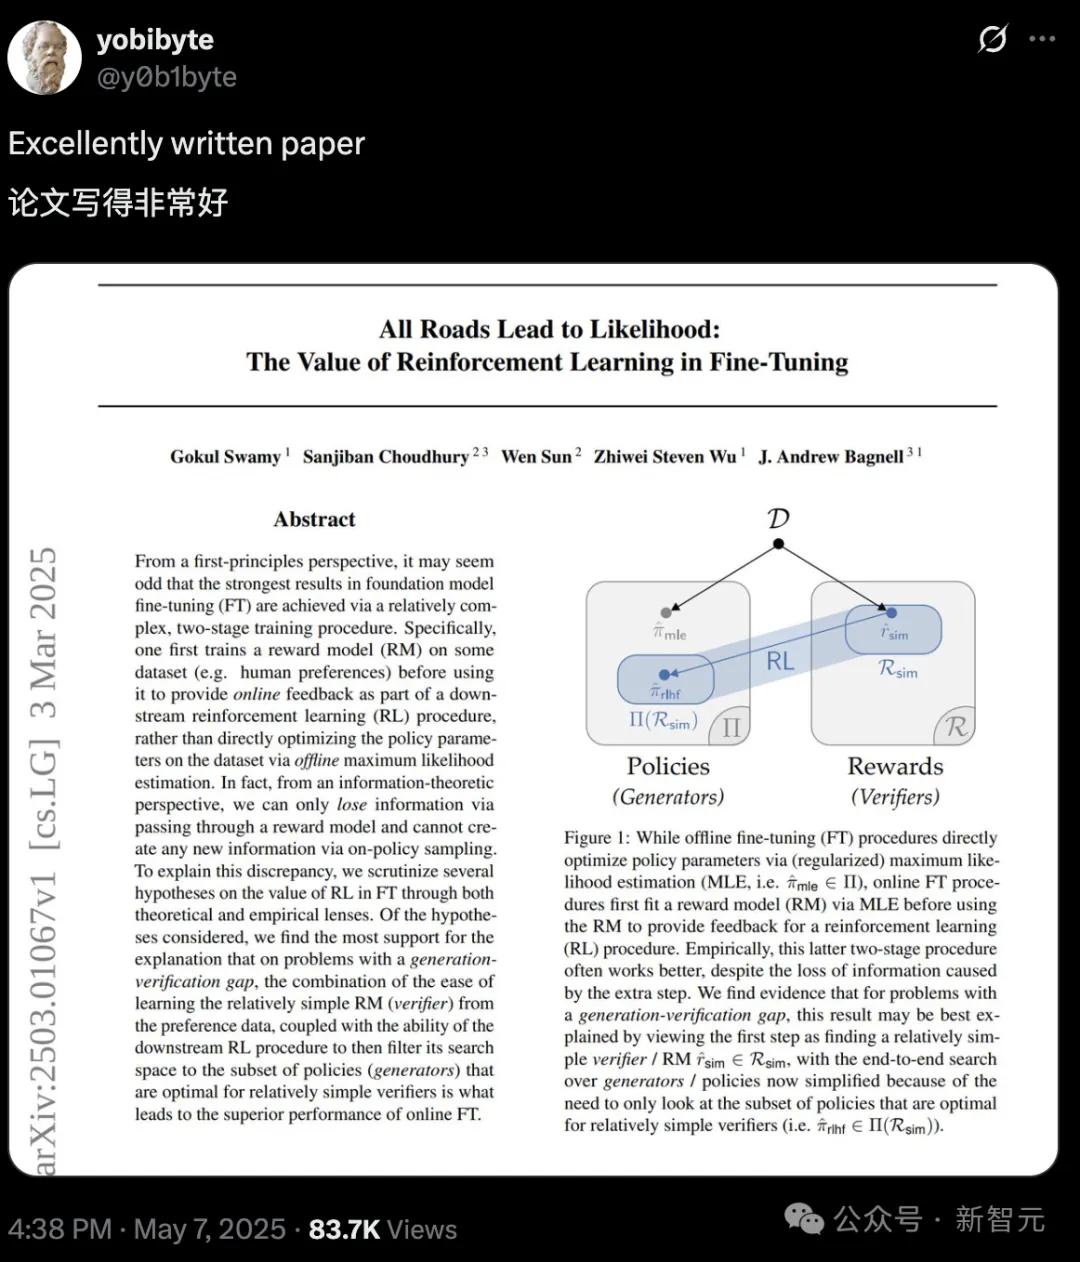
來自卡內基梅隆大學與康奈爾大學等機構、有華人學者參與的研究,從原理層面解釋了大語言模型微調為何採用兩階段訓練流程,指出RL微調本質上可視為統計過程,相關論文今年3月已公布於arXiv。
兩階段之謎
當前主流做法是先訓練獎勵模型為下游強化學習提供信號,再進行RL微調。這個初看違反直覺的兩階段流程為何最有效,一直缺乏根本性的解釋,新論文正是針對這一問題給出理論視角。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。