
 IXThinker·2025-05-21 13:20
華為昇騰優化MoE推理 專家調度延遲降10%
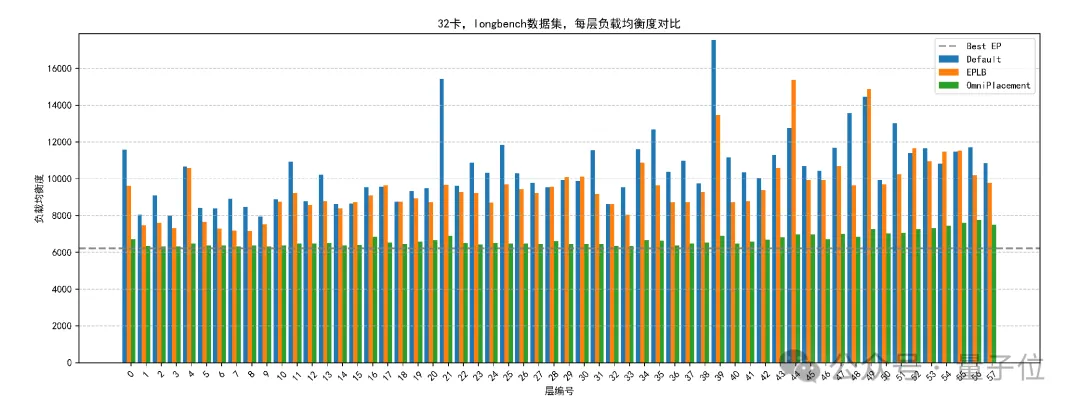
混合專家模型(MoE)是近期最受矚目的模型架構,但專家網絡負載不均會嚴重拖慢推理。華為持續披露昇騰超大規模MoE模型推理部署技術,新一輪技術報告針對專家調度作出優化,實現推理延遲降低10%。
MoE熱潮與難點
混合專家模型(MoE)近月大熱,其巧妙之處在於把不同任務分配給擅長處理的專家網絡,從而提升系統整體性能。然而專家網絡同時也是影響系統推理性能的關鍵因素之一。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。