
 IXThinker·2025-05-27 12:20
多模態長文理解測評:46款模型無一過128K關
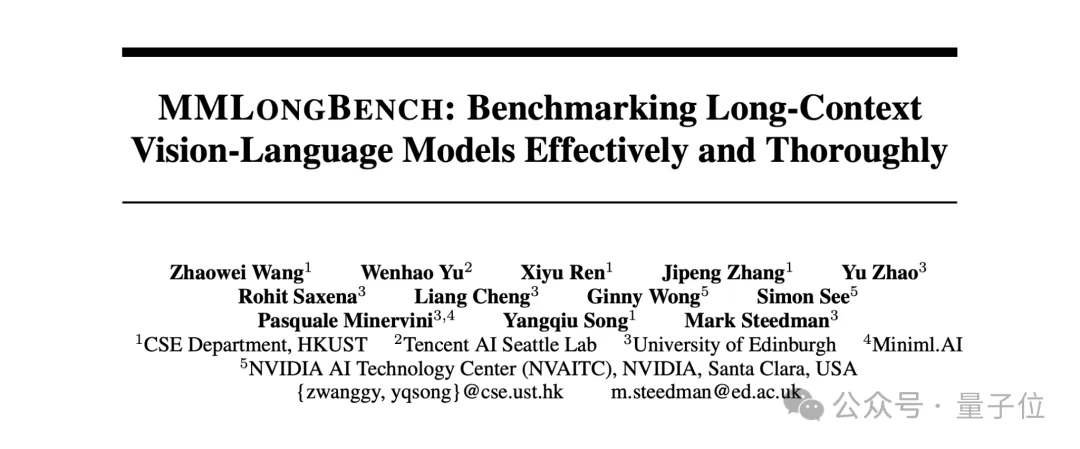
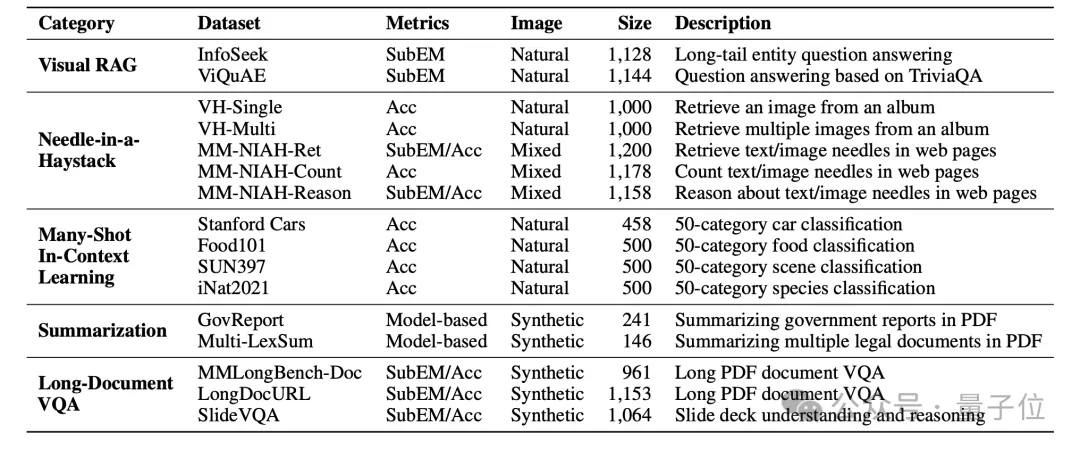
港科大、騰訊西雅圖AI Lab、愛丁堡大學、Miniml.AI與英偉達的研究人員聯合提出MMLongBench,為長上下文視覺語言模型提供綜合評測基準,涵蓋跨模態推理、資訊抽取、問答等多類任務,填補評測空白。
基準緣起
隨著多模態大模型單次推理的文本窗口快速擴展,可處理數百張圖像與較長交錯文本的長上下文視覺語言模型(LCVLMs)應運而生。但現有測試集多只關注單一任務,如大海撈針或長文檔問答,缺乏綜合標準。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。