
 IXThinker·2025-05-28 12:00
上海交大dLLM-Cache 為擴散語言模型提速
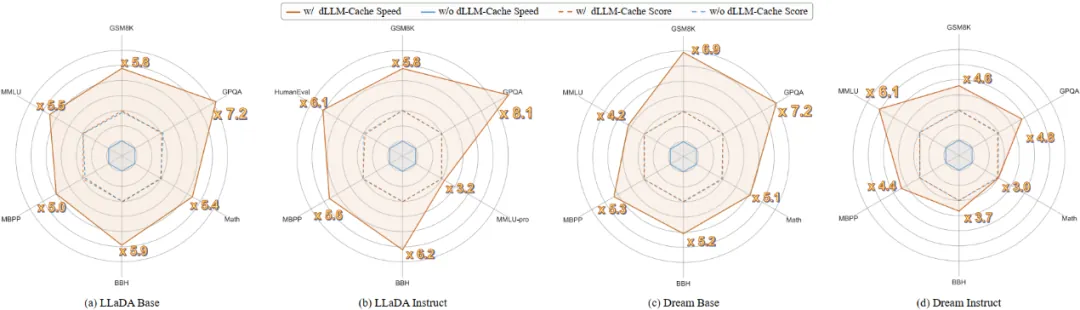
擴散式大語言模型(dLLMs)是新興技術路線,推理效率卻一直是短板。上海交通大學EPIC Lab團隊提出dLLM-Cache,號稱首個免訓練的dLLM推理加速方法,以即插即用的緩存機制實現提速。
方法原理
dLLM-Cache的核心思想,是在多步去噪過程中復用相鄰時間步上變化較小的特徵,只更新變化較大的部分,從而大幅降低計算量。方法無需訓練、即插即用,可直接套用於現有擴散語言模型,並保持原有生成質量。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。