
 IXThinker·2025-05-29 17:40
錯誤獎勵也能顯著提分 LLM配RL路線受質疑
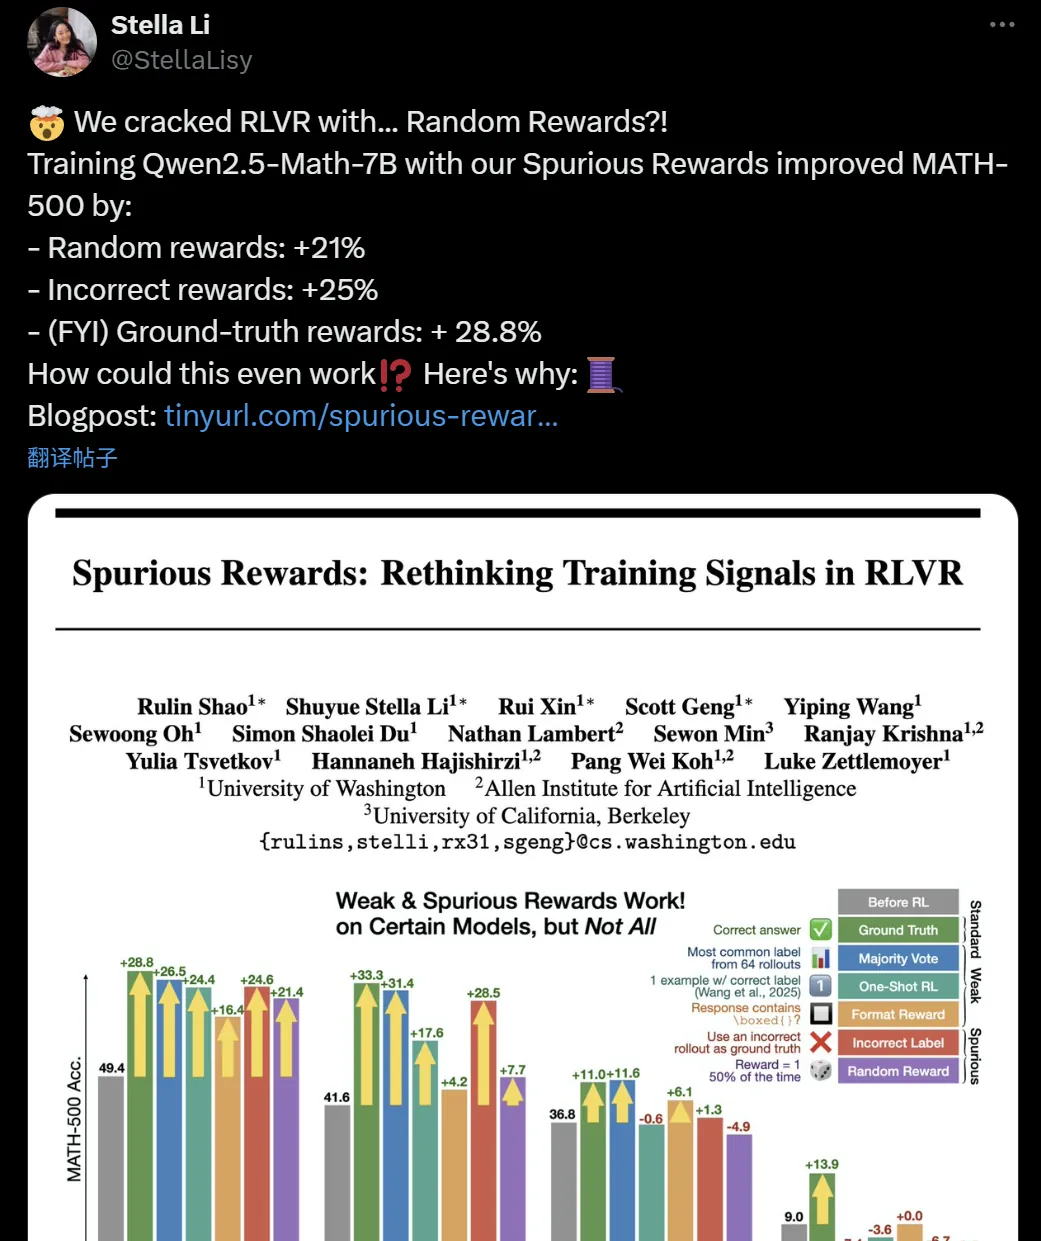
來自華盛頓大學、艾倫人工智能研究所與柏克萊的研究人員發表論文,質疑當前大語言模型結合強化學習的訓練路線,文章公開後隨即在AI圈引發廣泛討論。
論文核心發現
研究團隊的實驗顯示,即使使用虛假的獎勵信號訓練Qwen2系列模型,其在數學基準上的成績仍會顯著提升。這一結果令人質疑:大模型強化學習的收益,究竟來自真正的推理能力,還是另有原因。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。