
 IXThinker·2025-05-29 15:40
阿里通義PARSCALE:1.6B等效4.4B表現
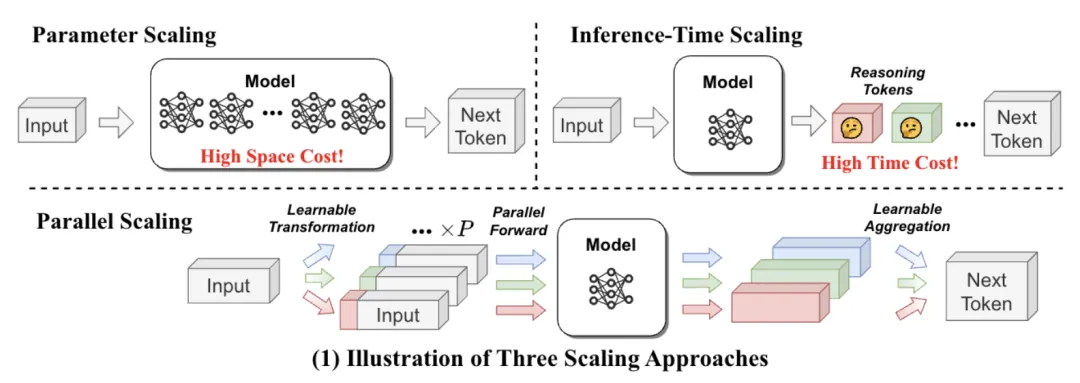
阿里通義團隊提出大模型優化新方法PARSCALE,被視為繼參數擴展與推理時間擴展之後的第三種Scaling路徑:1.6B模型可實現接近4.4B模型的性能,而記憶體佔用僅為後者的1/22。
方法靈感來源
現有LLM優化主要有參數擴展(如GPT-4)與推理時間擴展(如DeepSeek-R1)兩條路,但都會推高記憶體與時間成本。PARSCALE受無分類器引導(CFG)雙路徑推理機制啟發,將其並行思想從生成階段擴展至訓練與推理全流程。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。