
 IXThinker·2025-05-29 09:40
復旦字節推CAR框架 平衡推理精度與效率
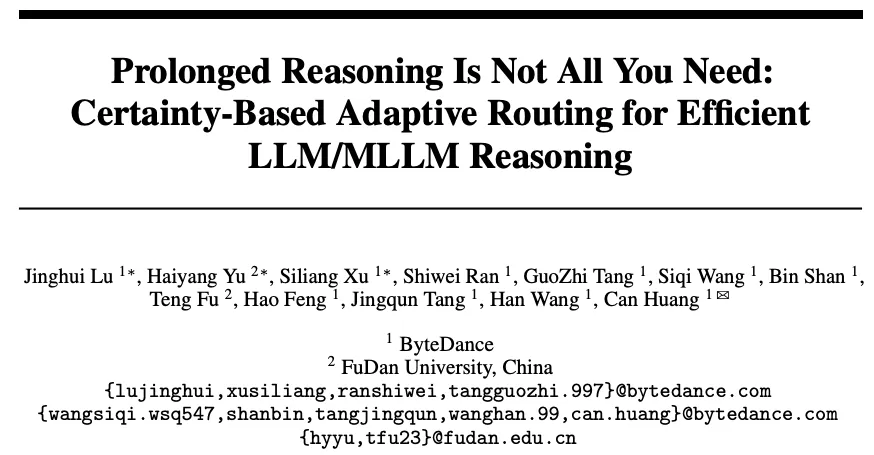
復旦大學與字節的研究團隊提出自適應推理框架CAR,針對過度依賴思維鏈(CoT)反而損害模型表現的問題,讓模型按自身置信度動態選擇簡短回答或長文本推理,兼顧準確性與效率。
長CoT的陷阱
推理能力的進步大幅提升了LLM與多模態大模型(MLLMs)的任務表現,但已有研究發現,長CoT推理並非總能提高準確率,處理簡單任務時甚至可能因冗長輸出而削弱表現,過度思考成為新的性能瓶頸。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。