
 IXThinker·2025-05-30 15:50
華為S-GRPO治大模型想太多 推理提速60%
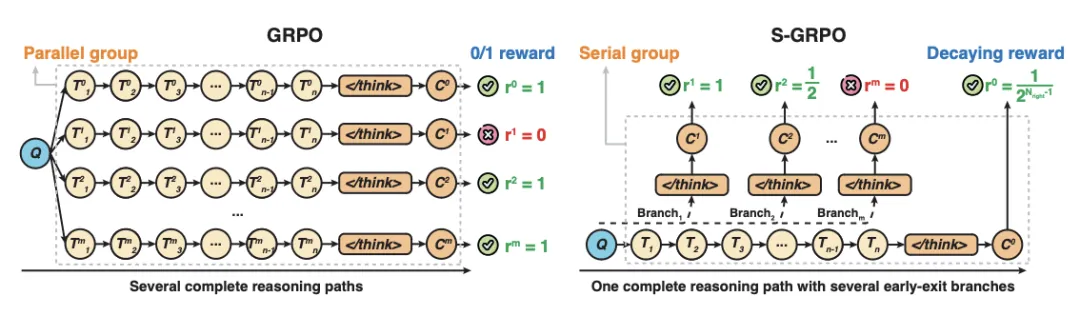
針對大模型回答冗長、思考過度的通病,華為提出高效推理方法S-GRPO,讓模型學會在思考充分後提前收結,在保持準確率的同時將推理速度提升60%。
冗餘思考瓶頸
大模型如Qwen3回答問題時常出現冗長、低效且無用的思考過程,拖慢回應速度;S-GRPO正是針對思維鏈「冗餘思考」瓶頸,屬首個在Qwen3上仍有效的同類方法。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。