
 IXThinker·2025-05-30 15:50
大模型僅憑自信學會推理 RLIF免外部獎勵信號
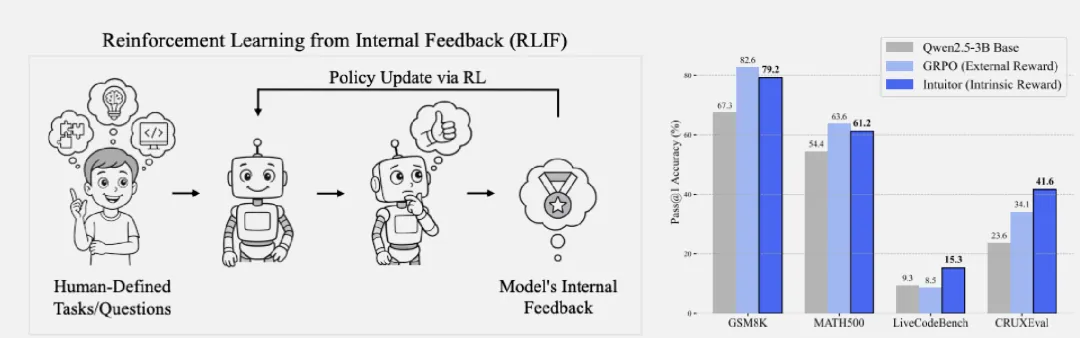
UC Berkeley團隊復現DeepSeek-R1式長思維鏈推理,提出無需外部獎勵信號與標註數據的新範式RLIF,僅靠模型自身置信度作內在獎勵,即可習得複雜推理能力。
以自信為獎勵
團隊共同一作Xuandong Zhao形容,大模型毋須接觸真實答案,僅透過優化自己的信心就能學會複雜推理;新方法完全不需外部獎勵或標註數據,以模型自身置信程度作內在獎勵信號。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。