
 IXThinker·2025-05-30 15:50
假獎勵訓練Qwen照升25% RLVR認知被顛覆
華盛頓大學博士生團隊發現,可驗證獎勵強化學習(RLVR)即使使用錯誤的獎勵信號,仍能顯著提升Qwen模型在數學任務上的表現,效果與真實獎勵相差無幾,顛覆既有認知。
虛假獎勵也有效
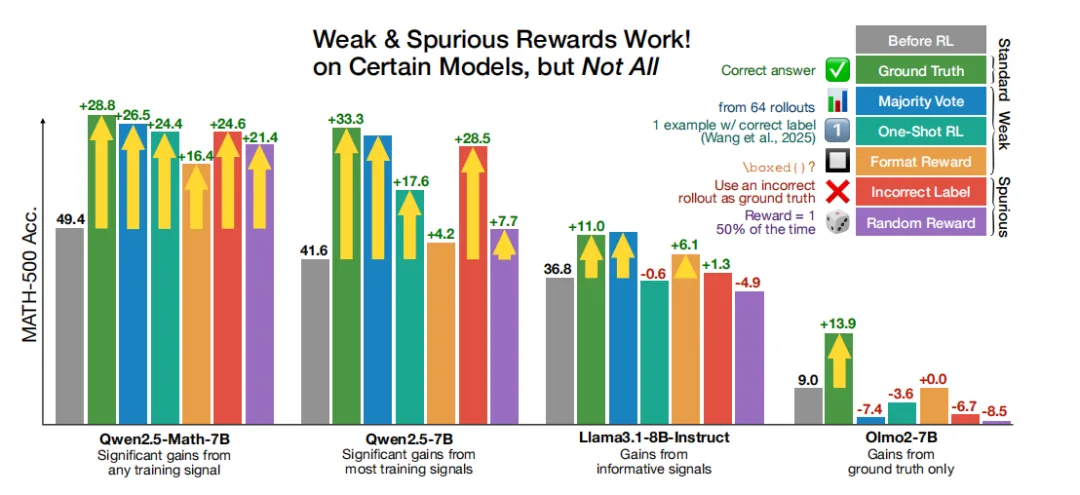
團隊以Qwen模型(尤其是數學版本)對虛假獎勵進行RLVR訓練,MATH-500的絕對準確率仍顯著提升約25%,與使用真實獎勵的效果相若,出乎不少人意料。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。